
PEFT documentation
BOFT
BOFT
الفراشة المتعامدة (BOFT) هي طريقة عامة مصممة لضبط نماذج الأساس. فهي تحسّن كفاءة المعلمات في نموذج الضبط — الضبط المتعامد (OFT)، مستلهمةً من تحويل فورييه السريع لكويلي-توكي، وتُظهر نتائج مواتية عبر ضبط نماذج أساس مختلفة، بما في ذلك محولات الرؤية الكبيرة، ونماذج اللغة الكبيرة، ونماذج الانتشار من النص إلى الصورة.
ملخص الورقة البحثية هو:
أصبحت النماذج التأسيسية الكبيرة شائعة الاستخدام، لكن تدريبها من الصفر مكلف للغاية. لذلك، يزداد أهمية تكييف هذه النماذج القوية بكفاءة مع المهام الفرعية. في هذه الورقة، ندرس نموذجًا مبدئيًا للضبط الدقيق — الضبط الدقيق المتعامد (OFT) — لتكييف المهام الفرعية. وعلى الرغم من إظهار قابلية تعميم جيدة، لا يزال OFT يستخدم عددًا كبيرًا نسبيًا من المعاملات القابلة للتدريب بسبب الأبعاد العالية للمصفوفات المتعامدة. لمعالجة ذلك، نبدأ بفحص OFT من منظور نقل المعلومات، ثم نحدد بعض المتطلبات الأساسية الرئيسية التي تتيح كفاءة أعلى في المعاملات. مستوحين من كيفية تمكين خوارزمية تحويل فورييه السريع Cooley-Tukey لنقل المعلومات بكفاءة، نقترح تمثيلًا متعامدًا فعالًا باستخدام هياكل الفراشة. نطبق هذا التمثيل على OFT، مما يخلق طريقة جديدة للضبط الدقيق بكفاءة المعاملات، تسمى الفراشة المتعامدة (BOFT). من خلال تضمين OFT كحالة خاصة، يقدم BOFT إطارًا عامًا للضبط الدقيق المتعامد. أخيرًا، نجري دراسة تجريبية شاملة لتكييف محولات الرؤية الكبيرة، ونماذج اللغة الكبيرة، ونماذج الانتشار من النص إلى الصورة مع مهام فرعية متنوعة في الرؤية واللغة.
يركز BOFT على الحفاظ على القدرات التوليدية لنموذج مُدرَّب مسبقًا، مع كفاءة أعلى بكثير في استخدام المعاملات مقارنة بـ OFT القياسي. وكما هو الحال مع OFT، يحافظ BOFT على نفس التشابه الجيبوي (hyperspherical energy) بين جميع أزواج العصبونات في طبقة معينة، وذلك من خلال تطبيق تحويل متعامد على مصفوفة الأوزان للنموذج المُدرَّب مسبقًا، مما يضمن الحفاظ على العلاقات الدلالية بين العصبونات.
بدلاً من استخدام مصفوفة متعامدة قطرية كتلية، يعامل BOFT التحويل المتعامد إلى حاصل ضرب مصفوفات فراشة متناثرة (التي عُرضت لأول مرة في تحويل فورييه السريع Cooley–Tukey). على عكس الدورانات القطرية الكتلية في OFT، التي تخلط المدخلات داخل كل كتلة فقط، تضمن بنية الفراشة أن كل مدخل يمكن أن يؤثر على كل مخرج، مما ينتج عنه اتصال كثيف باستخدام O(d log d) من المعلمات فقط. يحافظ هذا التحليل على القدرة التعبيرية مع تقليل عدد المعلمات بشكل كبير مقارنةً بـ OFT (على حساب وقت الحساب).
عملياً، يضرب BOFT كل مصفوفة أوزان مُسبقة التدريب بسلسلة من العوامل المتعامدة ذات البنية الفراشة، مما يتيح تدويراً فعالاً وقابلاً للتعبير للخلايا العصبية. وهذا يجعل BOFT مناسباً بشكل جيد للتوليد القابل للتحكم والمهام التي يكون فيها الحفاظ على تمثيل الموضوع للنموذج المُسبق التدريب أمراً بالغ الأهمية، مع إمكانية التوسع إلى نماذج أكبر بتكلفة أقل للذاكرة والحوسبة.
يمكن تطبيق BOFT على أي مجموعة فرعية من مصفوفات الأوزان في الشبكة العصبية لتقليل عدد المعلمات القابلة للتدريب. بالنظر إلى الطبقات المستهدفة لحقن معلمات BOFT، يمكن تحديد عدد المعلمات القابلة للتدريب بناءً على حجم مصفوفات الأوزان.
نظرة عامة على الاختبارات
دمج أوزان BOFT في النموذج الأساسي
بشكل مشابه لـ LoRA، يمكن دمج الأوزان التي تعلّمها BOFT في مصفوفات الأوزان المُسبقة التدريب باستخدام دالة ~BOFTModel.merge_and_unload(). تدمج هذه الدالة أوزان المُكيّف مع النموذج الأساسي، مما يتيح لك استخدام النموذج المُدمج الجديد بفعالية كنموذج مستقل.
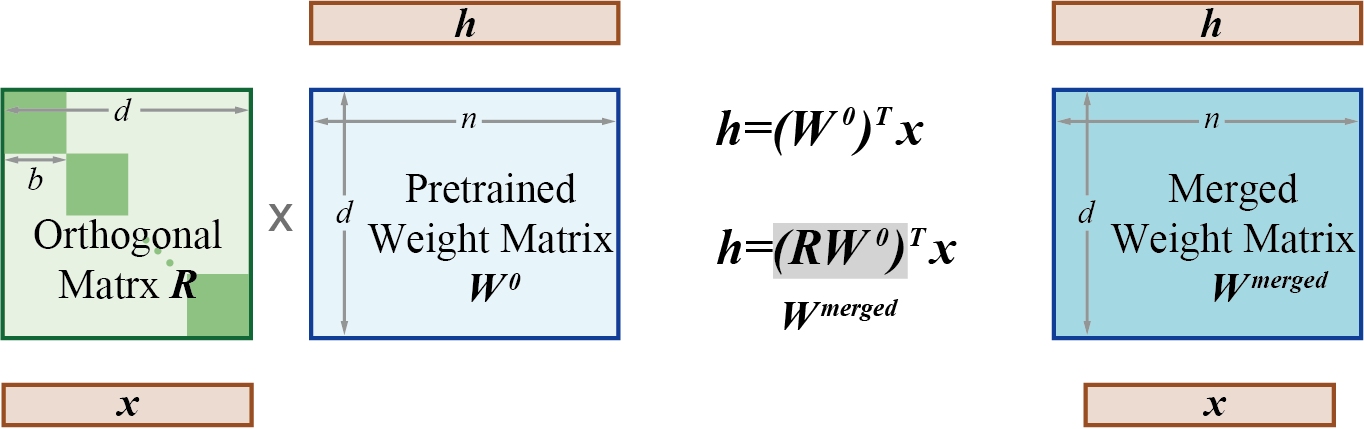
يعمل هذا لأن مصفوفة الأوزان المتعامدة (R في المخطط أعلاه) ومصفوفات الأوزان المُدرَّبة مسبقًا منفصلة أثناء التدريب. لكن بمجرد اكتمال التدريب، يمكن دمج هذه الأوزان فعليًا (بضربها) في مصفوفة أوزان جديدة مكافئة.
مثال على استخدام BOFT
لمثال على تطبيق طريقة BOFT على مهام مختلفة، يُرجى الرجوع إلى الأدلة التالية:
اطّلع على الأدلة التالية خطوة بخطوة حول كيفية ضبط نموذج باستخدام BOFT:
لمهمة تصنيف الصور، يمكن تهيئة إعدادات BOFT لنموذج DinoV2 على النحو التالي:
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
واجهة برمجة التطبيقات
BOFTConfig
فئة peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
المعاملات
- boft_block_size (
int) — حجم كتلة مصفوفة BOFT عبر الطبقات المختلفة، معبَّرًا عنه بـint. يؤدي اختيار أحجام كتل أكبر إلى الحصول على مصفوفات تحديث أكثر كثافة مع عدد أكبر من المعاملات القابلة للتدريب. اخترboft_block_sizeبحيث يكون قابلاً للقسمة على بُعد مدخلات معظم الطبقات (in_features)، مثل 4 أو 8 أو 16. كما يُرجى تحديدboft_block_sizeأوboft_block_numفقط، وليس كلاهما في آنٍ واحد، أو ترك كليهما عند القيمة 0، لأنboft_block_size×boft_block_numيجب أن يساوي بُعد مدخلات الطبقة. - boft_block_num (
int) — عدد كتل BOFT في كل طبقة مُحقنة. كلما زادboft_block_num، أصبحت مصفوفات التحديث أكثر تمييعاً مع عدد أقل من المعاملات القابلة للتدريب. ملاحظة، يرجى اختيارboft_block_numبحيث يكون قابلاً للقسمة على بُعد مدخلات معظم الطبقات (in_features)، مثل 4 أو 8 أو 16. حدد إماboft_block_sizeأوboft_block_numفقط، وليس كلاهما في نفس الوقت أو تركهما عند القيمة 0، لأنboft_block_size×boft_block_numيجب أن يساوي بُعد مدخلات الطبقة. - boft_n_butterfly_factor (
int) — عدد عوامل الفراشة عبر طبقات مختلفة. عندboft_n_butterfly_factor=1، يكون BOFT مطابقًا تمامًا لـ OFT العادي، أما عندboft_n_butterfly_factor=2، فإن حجم الكتلة الفعّال لـ OFT يصبح ضعف حجمه الأصلي، بينما ينخفض عدد الكتل إلى النصف. - target_modules (
Union[List[str],str]) — أسماء الوحدات التي سيتم تطبيق المُكيّف عليها. - exclude_modules (
Optional[Union[List[str], str]]) — أسماء الوحدات التي لا يُطبَّق عليها المُكيّف. عند تمرير نص، يتم إجراء مطابقة باستخدام تعبير نمطي. عند تمرير قائمة من النصوص، يتم إجراء مطابقة دقيقة أو يُتحقق مما إذا كان اسم الوحدة ينتهي بأي من النصوص المُمرَّرة. - boft_dropout (
float) — احتمالية الإسقاط الضربي، من خلال ضبط كتل OFT على الهوية أثناء التدريب، على غرار طبقة الإسقاط في LoRA. - fan_in_fan_out (
bool) — اضبط هذا على True إذا كانت الطبقة التي سيتم استبدالها تخزن الأوزان على شكل (fan_in, fan_out). على سبيل المثال، يستخدم gpt-2Conv1Dالذي يخزن الأوزان على شكل (fan_in, fan_out)، وبالتالي يجب ضبط هذا علىTrue. - bias (
str) — نوع الانحياز لـ BOFT. يمكن أن يكون ‘none’ أو ‘all’ أو ‘boft_only’. إذا كان ‘all’ أو ‘boft_only’، فسيتم تحديث الانحيازات المقابلة أثناء التدريب. انتبه إلى أن هذا يعني أنه حتى عند تعطيل المحولات، لن ينتج النموذج نفس المخرجات التي كان سينتجها النموذج الأساسي دون تكييف. - modules_to_save (
List[str]) — قائمة الوحدات التي يجب ضبطها لتكون قابلة للتدريب وحفظها في نقطة الفحص النهائية، بخلاف طبقات BOFT. - layers_to_transform (
Union[List[int],int]) — مؤشرات الطبقات التي سيتم تحويلها، إذا تم تحديد هذا الحُجج، فسيتم تطبيق تحويلات BOFT على مؤشرات الطبقات المحددة في هذه القائمة. إذا تم تمرير عدد صحيح واحد، فسيتم تطبيق تحويلات BOFT على الطبقة الموجودة عند هذا المؤشر. - layers_pattern (
Optional[Union[List[str], str]]) — اسم نمط الطبقة، يُستخدم فقط إذا كانlayers_to_transformمختلفاً عنNoneوإذا لم يكن نمط الطبقة ضمن أنماط الطبقات الشائعة. يجب أن يستهدف هذاnn.ModuleListالخاص بالنموذج، والذي يُسمى غالباً'layers'أو'h'.
هذه هي فئة الإعدادات لتخزين إعدادات BOFTModel.
BOFTModel
فئة peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
المعاملات
- model (transformers.PreTrainedModel) — النموذج الذي سيتم تكييفه.
- config (BOFTConfig) — إعدادات نموذج BOFT.
- adapter_name (
str) — اسم المُكيّف، القيمة الافتراضية هي"default". - low_cpu_mem_usage (
bool,optional, defaults toFalse) — إنشاء أوزان مُكيّف فارغة على جهاز meta. مفيد لتسريع عملية التحميل.
يعيد
torch.nn.Module
نموذج BOFT.
ينشئ نموذج BOFT ونموذج OFT من نموذج transformers مُدرَّب مسبقًا. الورقة البحثية: https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
مثال:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)الخصائص:
- النموذج (transformers.PreTrainedModel) — النموذج الذي سيتم تكييفه.
- peft_config (BOFTConfig): إعدادات نموذج BOFT.