
Transformers documentation
GLM-5, GLM-5.1, GLM-5.2, GLM-5.3
Bu model, 2026-02-17 tarihinde HF papers'ta yayımlandı ve 2026-02-09 tarihinde Hugging Face Transformers'a katkıda bulunuldu.


GLM-5, GLM-5.1, GLM-5.2, GLM-5.3
Genel Bakış
GLM-5, GLM-5.1, GLM-5.2 ve GLM-5.3 dil modelleri bu sınıfı kullanır. transformers'taki uygulama bir MTP katmanı içermez.
GLM-5.3
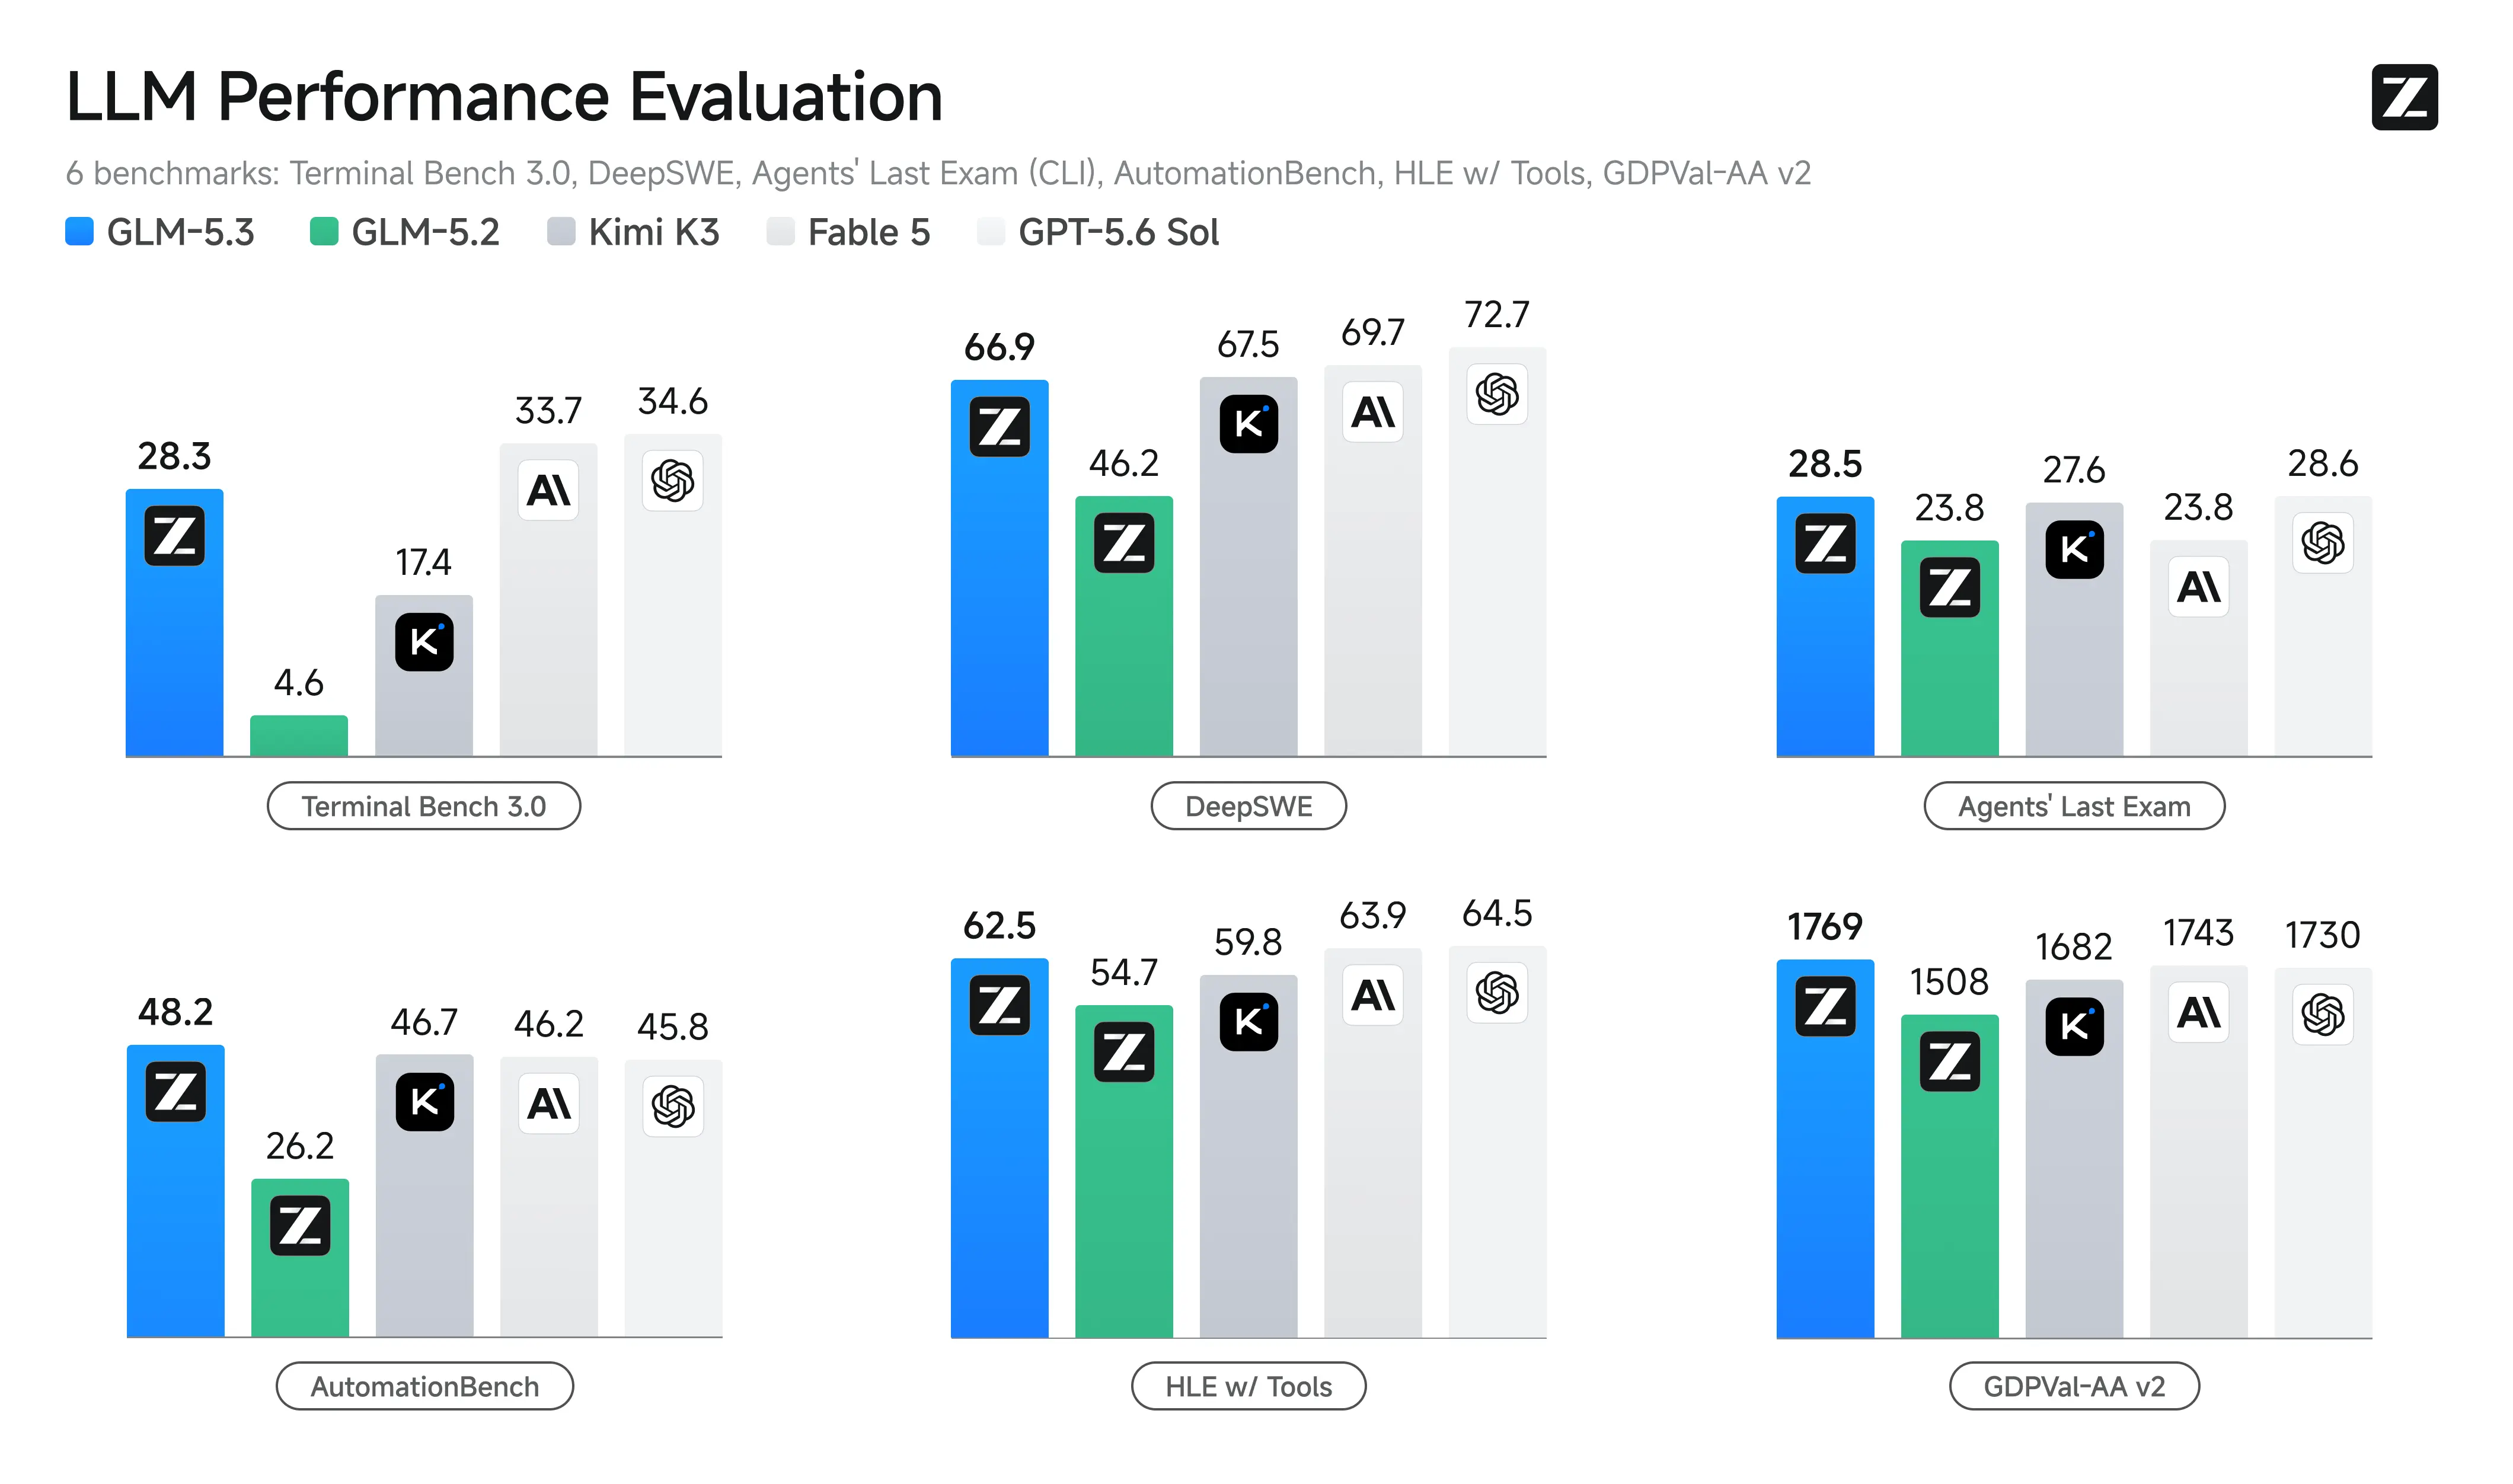
GLM-5.3, GLM-5.2 ile aynı temel modeli kullanır; tüm kazanımlar eğitim sonrası aşamadan kaynaklanır. GLM-5.2'ye kıyasla karmaşık kodlama ve uzun vadeli görevlerde çok daha başarılıdır:
- Daha Güçlü Kodlama: GLM-5.3, kodlama için en yetenekli açık ağırlıklı modeldir ve kendi içimizdeki Z.ai Code Bench üzerinde GLM-5.2'ye kıyasla %50'lik bir iyileşme göstermektedir. Ayrıca Terminal Bench 3.0 ve Agents’ Last Exam dahil olmak üzere halka açık benchmark'larda açık kaynak SOTA'ya ulaşmaktadır.
- Ortaya Çıkan Siber Yetenek: Post-eğitimi ölçeklendirdikçe, siber yetenek beklentilerimizin ötesinde daha hızlı gelişti. GLM-5.3, zafiyet keşfi için CyberGym'da en ileri düzeyde performans sergilemekte olup, kazanımları istismar zincirinin daha üst kademelerinde en yüksek seviyeye ulaşmaktadır; bu kademelerde istismar benchmark'larında GLM-5.2'nin performansından iki katından fazla bir artış göstermektedir.
GLM-5.2
GLM-5.2, uzun vadeli görevler için en yeni amiral gemisi modelimiz. Önceki sürümü GLM-5.1'e kıyasla uzun vadeli görev yetkinliğinde önemli bir sıçrama temsil etmekte ve bu yetkinliği ilk kez güçlü 1M token bağlamında sunmaktadır.
GLM-5.2'nin yeni yetenekleri şunları içerir:
- Sağlam 1M Bağlam: Uzun vadeli işleri kararlı bir şekilde sürdüren sağlam 1M jetonluk bağlam
- Esnek Efor ile Gelişmiş Kodlama: Performans ve gecikme dengesini kurmak için birden fazla düşünme efor seviyesiyle daha güçlü kodlama yetenekleri
- İyileştirilmiş Mimari: Her dört seyrek dikkat katmanında da aynı indeksleyiciyi yeniden kullanan IndexShare öneriyoruz; bu sayede 1M bağlam uzunluğunda token başına FLOP'lar 2,9 kat azaltılmaktadır. Ayrıca GLM-5.2'nin spekülatif çözümleme için MTP katmanını iyileştirerek kabul uzunluğunu %20'ye kadar artırdık.
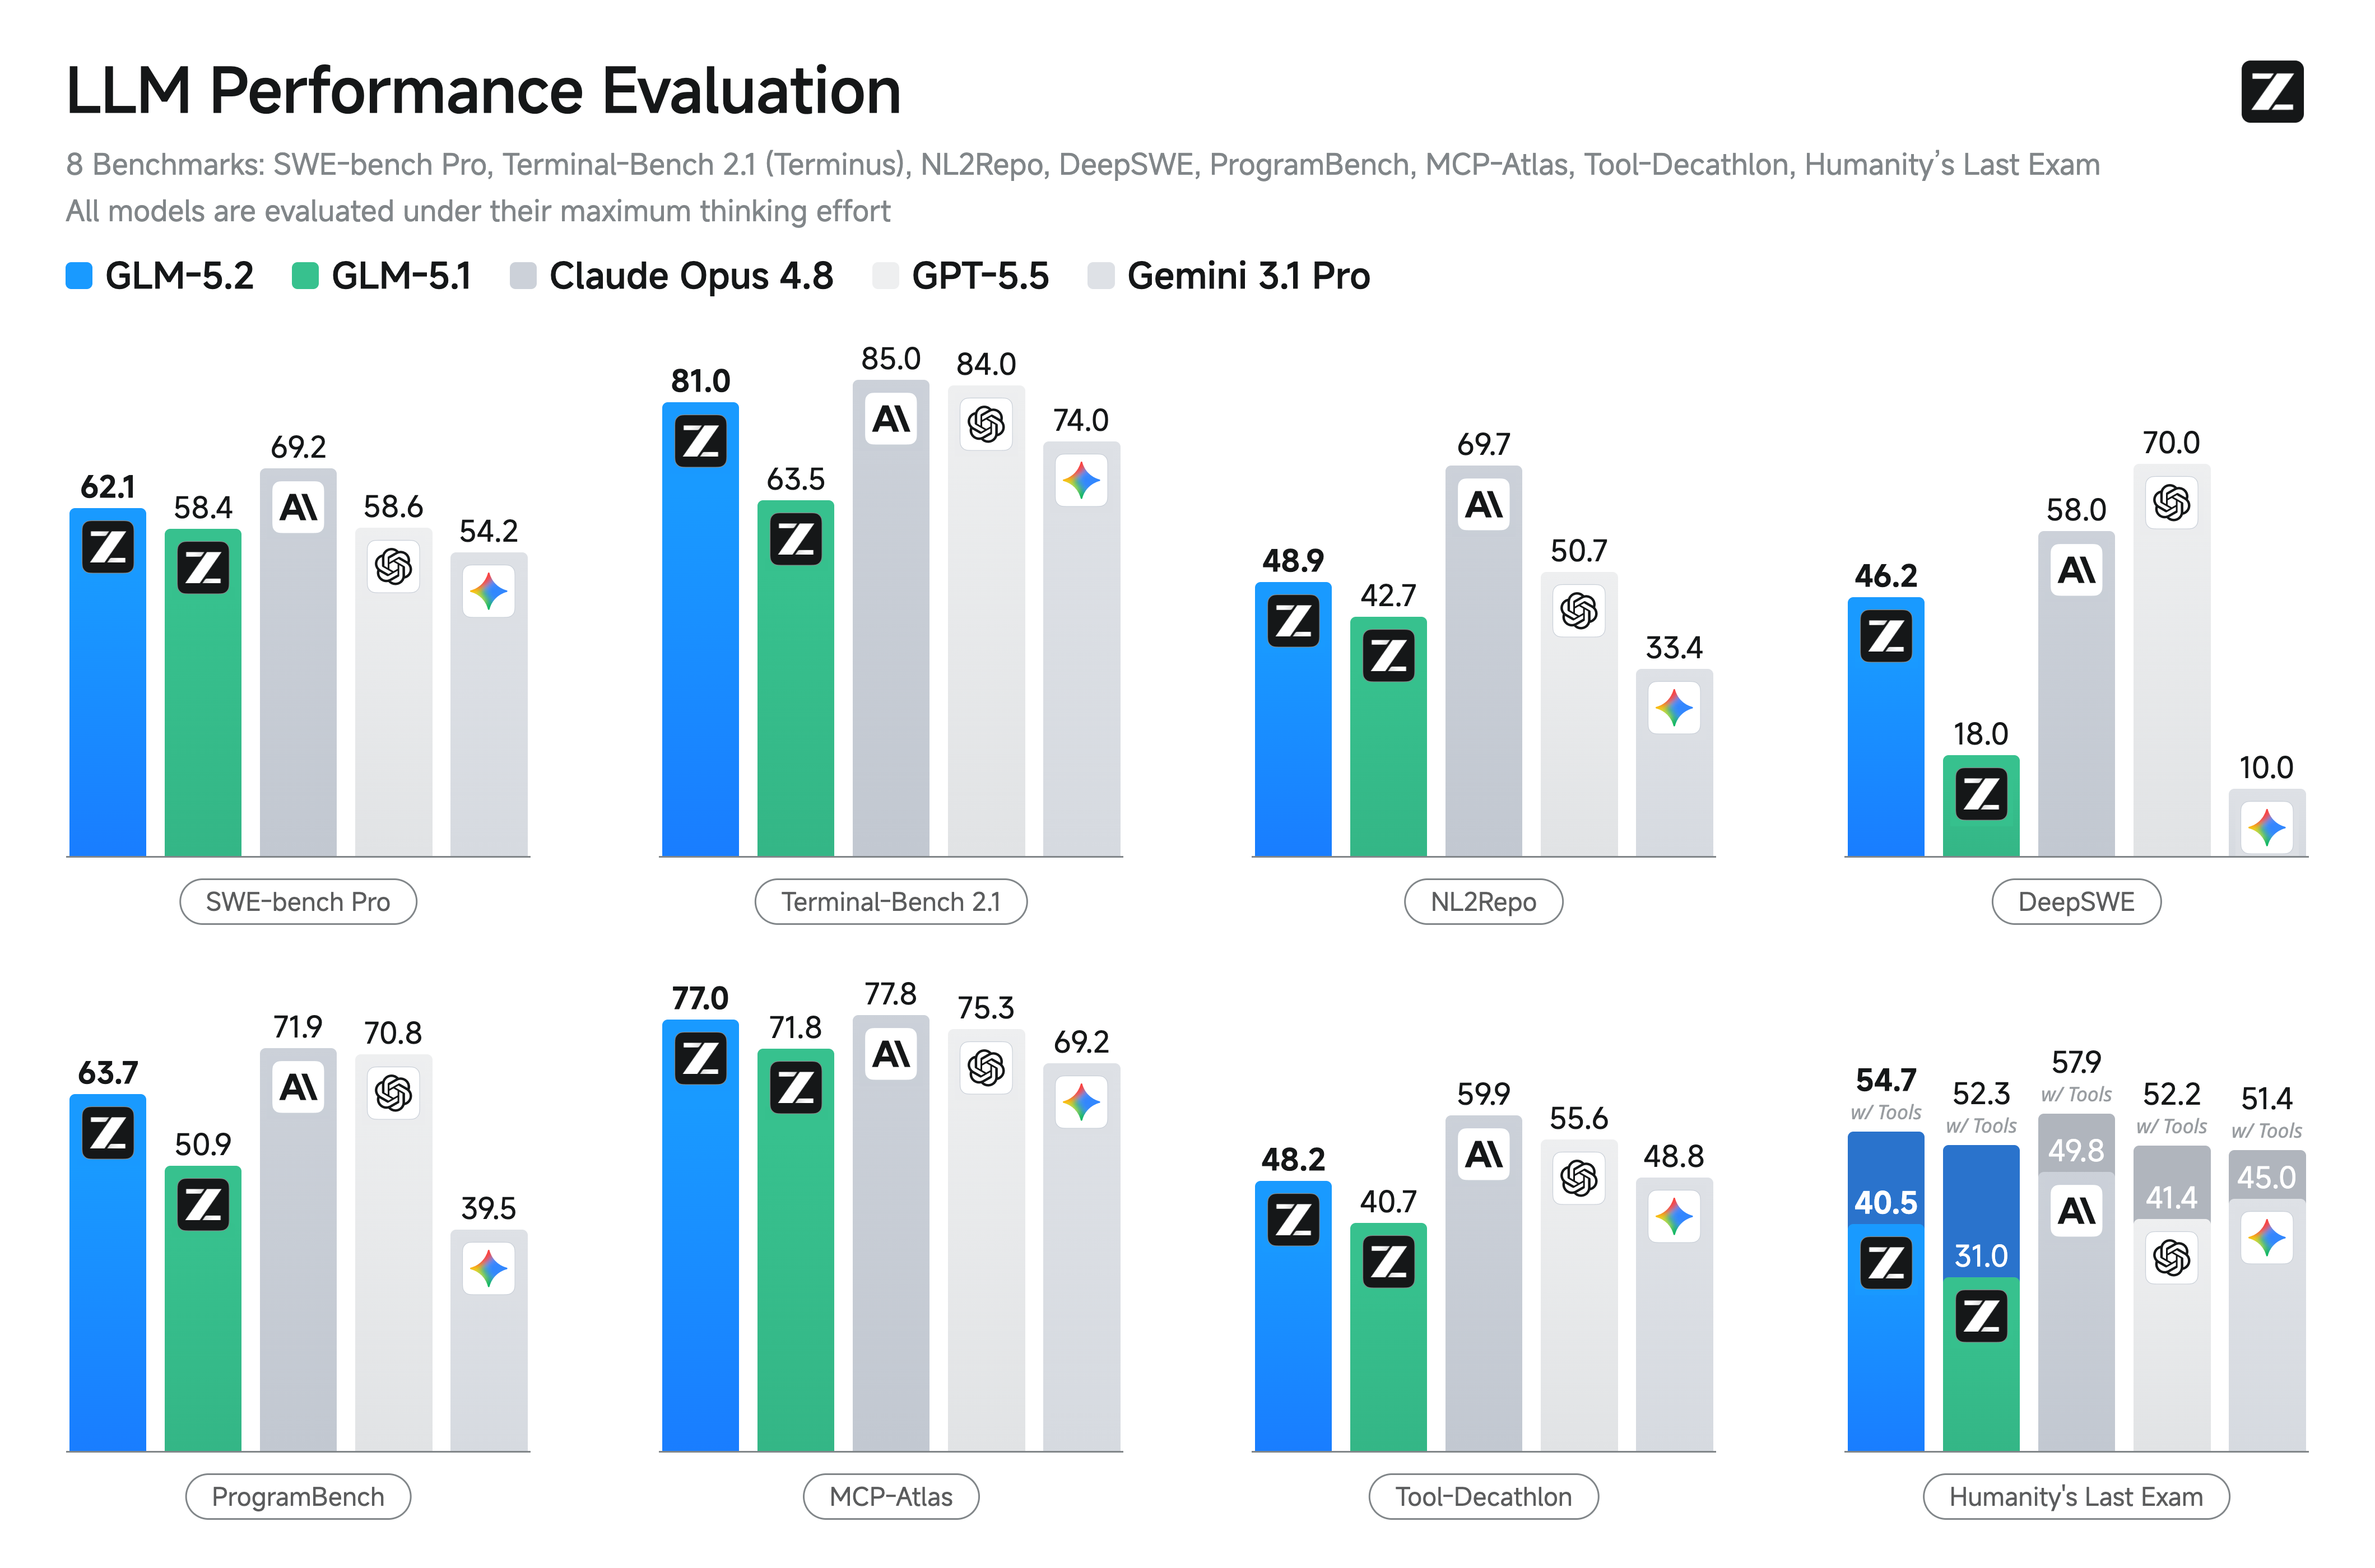
Standart kodlama ölçütlerinde GLM-5.2, açık kaynaklı modeller arasında en güçlü olanıdır ve GLM-5.1'e kıyasla belirgin bir iyileşme gösterir: Terminal-Bench 2.1'de 81.0'a karşılık 62.0 ve SWE-bench Pro'da 62.1'e karşılık 58.4. Ayrıca kapalı kaynaklı sınır modellerine olan farkın büyük bir kısmını kapatır — Terminal-Bench 2.1'de (81.0) Claude Opus 4.8'in (85.0) birkaç puan gerisinde kalır — ve Gemini 3.1 Pro'nun önünde yer almaya devam eder.
Daha fazla ayrıntı için blogumuza göz atın.
GLM-5.1
GLM-5.1, ajan tabanlı mühendislik için bir sonraki nesil amiral gemisi modelimizdir ve önceki sürümüne kıyasla belirgin şekilde daha güçlü kodlama yeteneklerine sahiptir. SWE-Bench Pro'da en iyi performansı (state-of-the-art) elde ederken, NL2Repo (repo üretimi) ve Terminal-Bench 2.0 (gerçek dünya terminal görevleri) üzerinde GLM-5'i açık bir farkla geride bırakmaktadır.
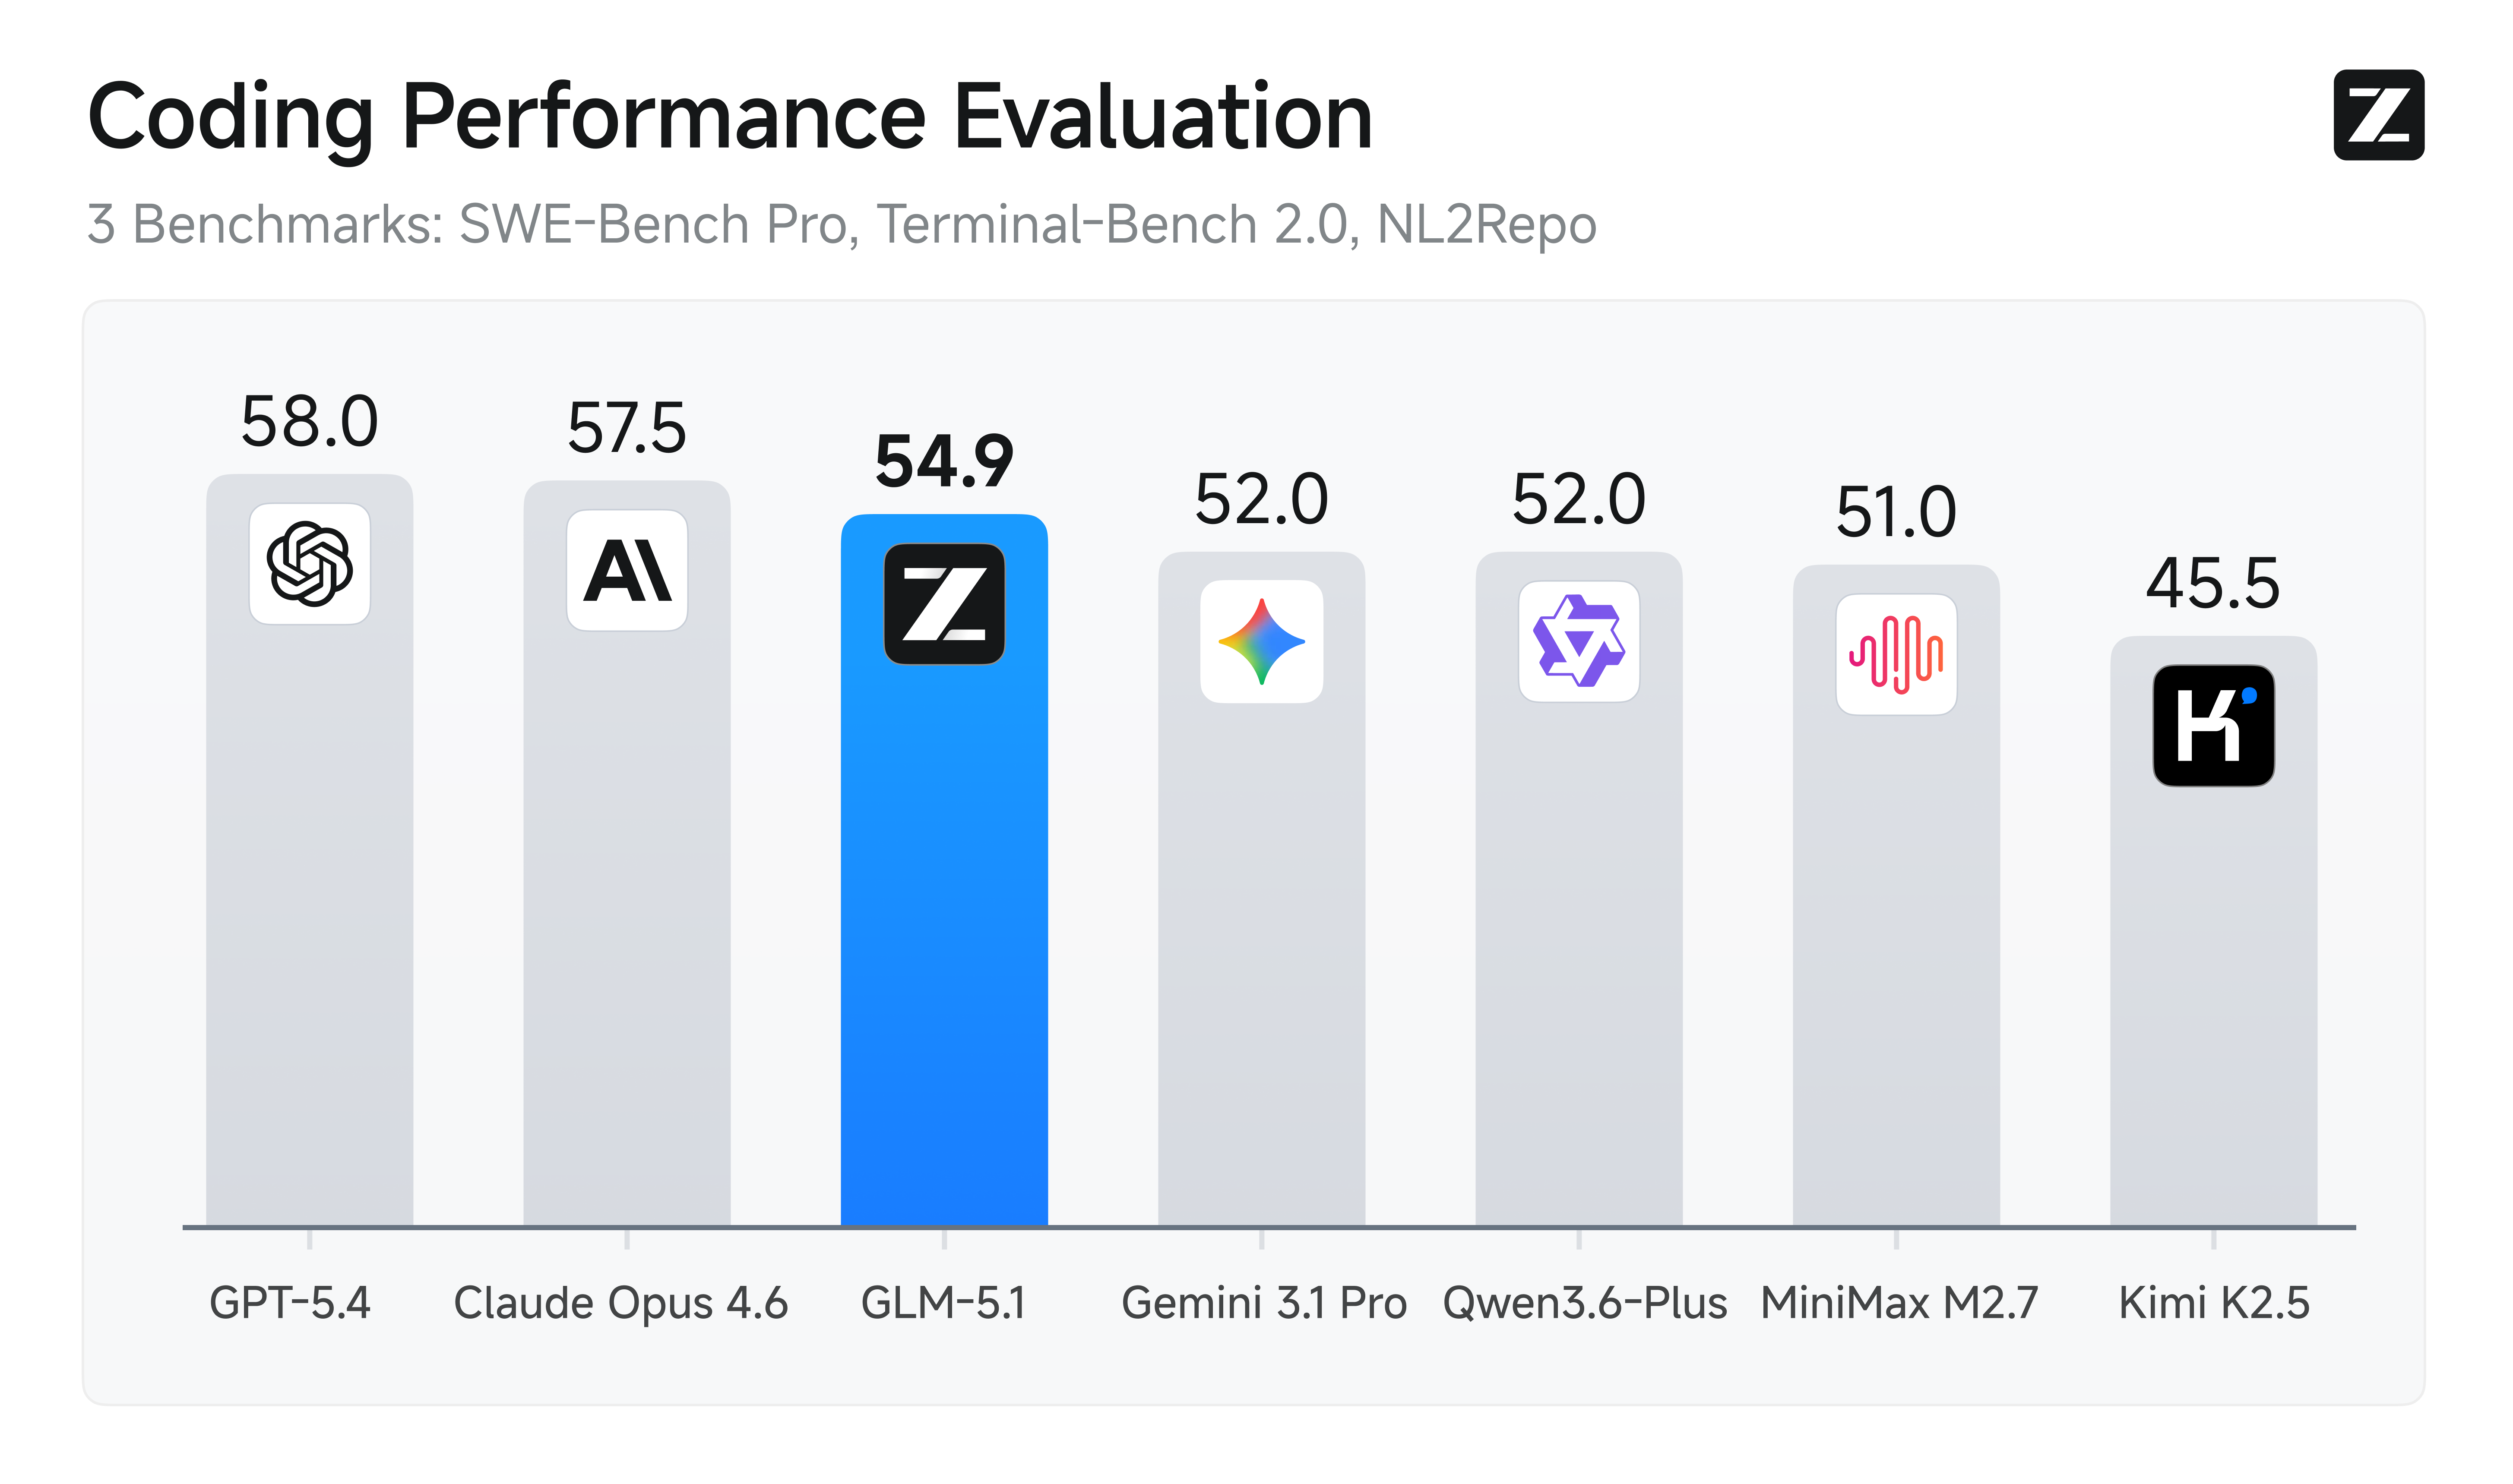
Ancak en anlamlı sıçrama, ilk geçiş performansının ötesine geçer. Önceki modeller—GLM-5 dahil—genellikle repertuarlarını erken tüketir: hızlı ilk kazanımlar için tanıdık teknikleri uygularlar, ardından bir plato oluştururlar. Onlara daha fazla zaman tanımak işe yaramaz.
Buna karşılık GLM-5.1, çok daha uzun zaman dilimlerinde ajan tabanlı görevlerde etkinliğini koruyacak şekilde tasarlanmıştır. Modelin belirsiz problemleri daha iyi bir yargıyla ele aldığını ve daha uzun oturumlarda verimliliğini sürdürdüğünü gözlemledik. Karmaşık problemleri parçalara ayırıyor, deneyler yürütüyor, sonuçları okuyor ve engelleri gerçek bir hassasiyetle tespit ediyor. Düşünce sürecini tekrar gözden geçirerek ve stratejisini sürekli tekrar eden iterasyonlarla revize ederek GLM-5.1, yüzlerce tur ve binlerce araç çağrısı boyunca optimizasyonu sürdürüyor. Çalışma süresi uzadıkça sonuç da iyileşiyor.
GLM-5
GLM-5 (GlmMoeDsa), 744B parametreli bir mixture-of-experts modelidir ve token başına 40B aktif parametreye sahiptir; verimli 200K token bağlam işleme için DeepSeek Sparse Attention (DSA) kullanır. Model tamamen Huawei Ascend çiplerinde eğitilmiştir ve akıl yürütme ile uzun bağlam benchmark'larında sınır düzeyinde performans sergilemektedir.
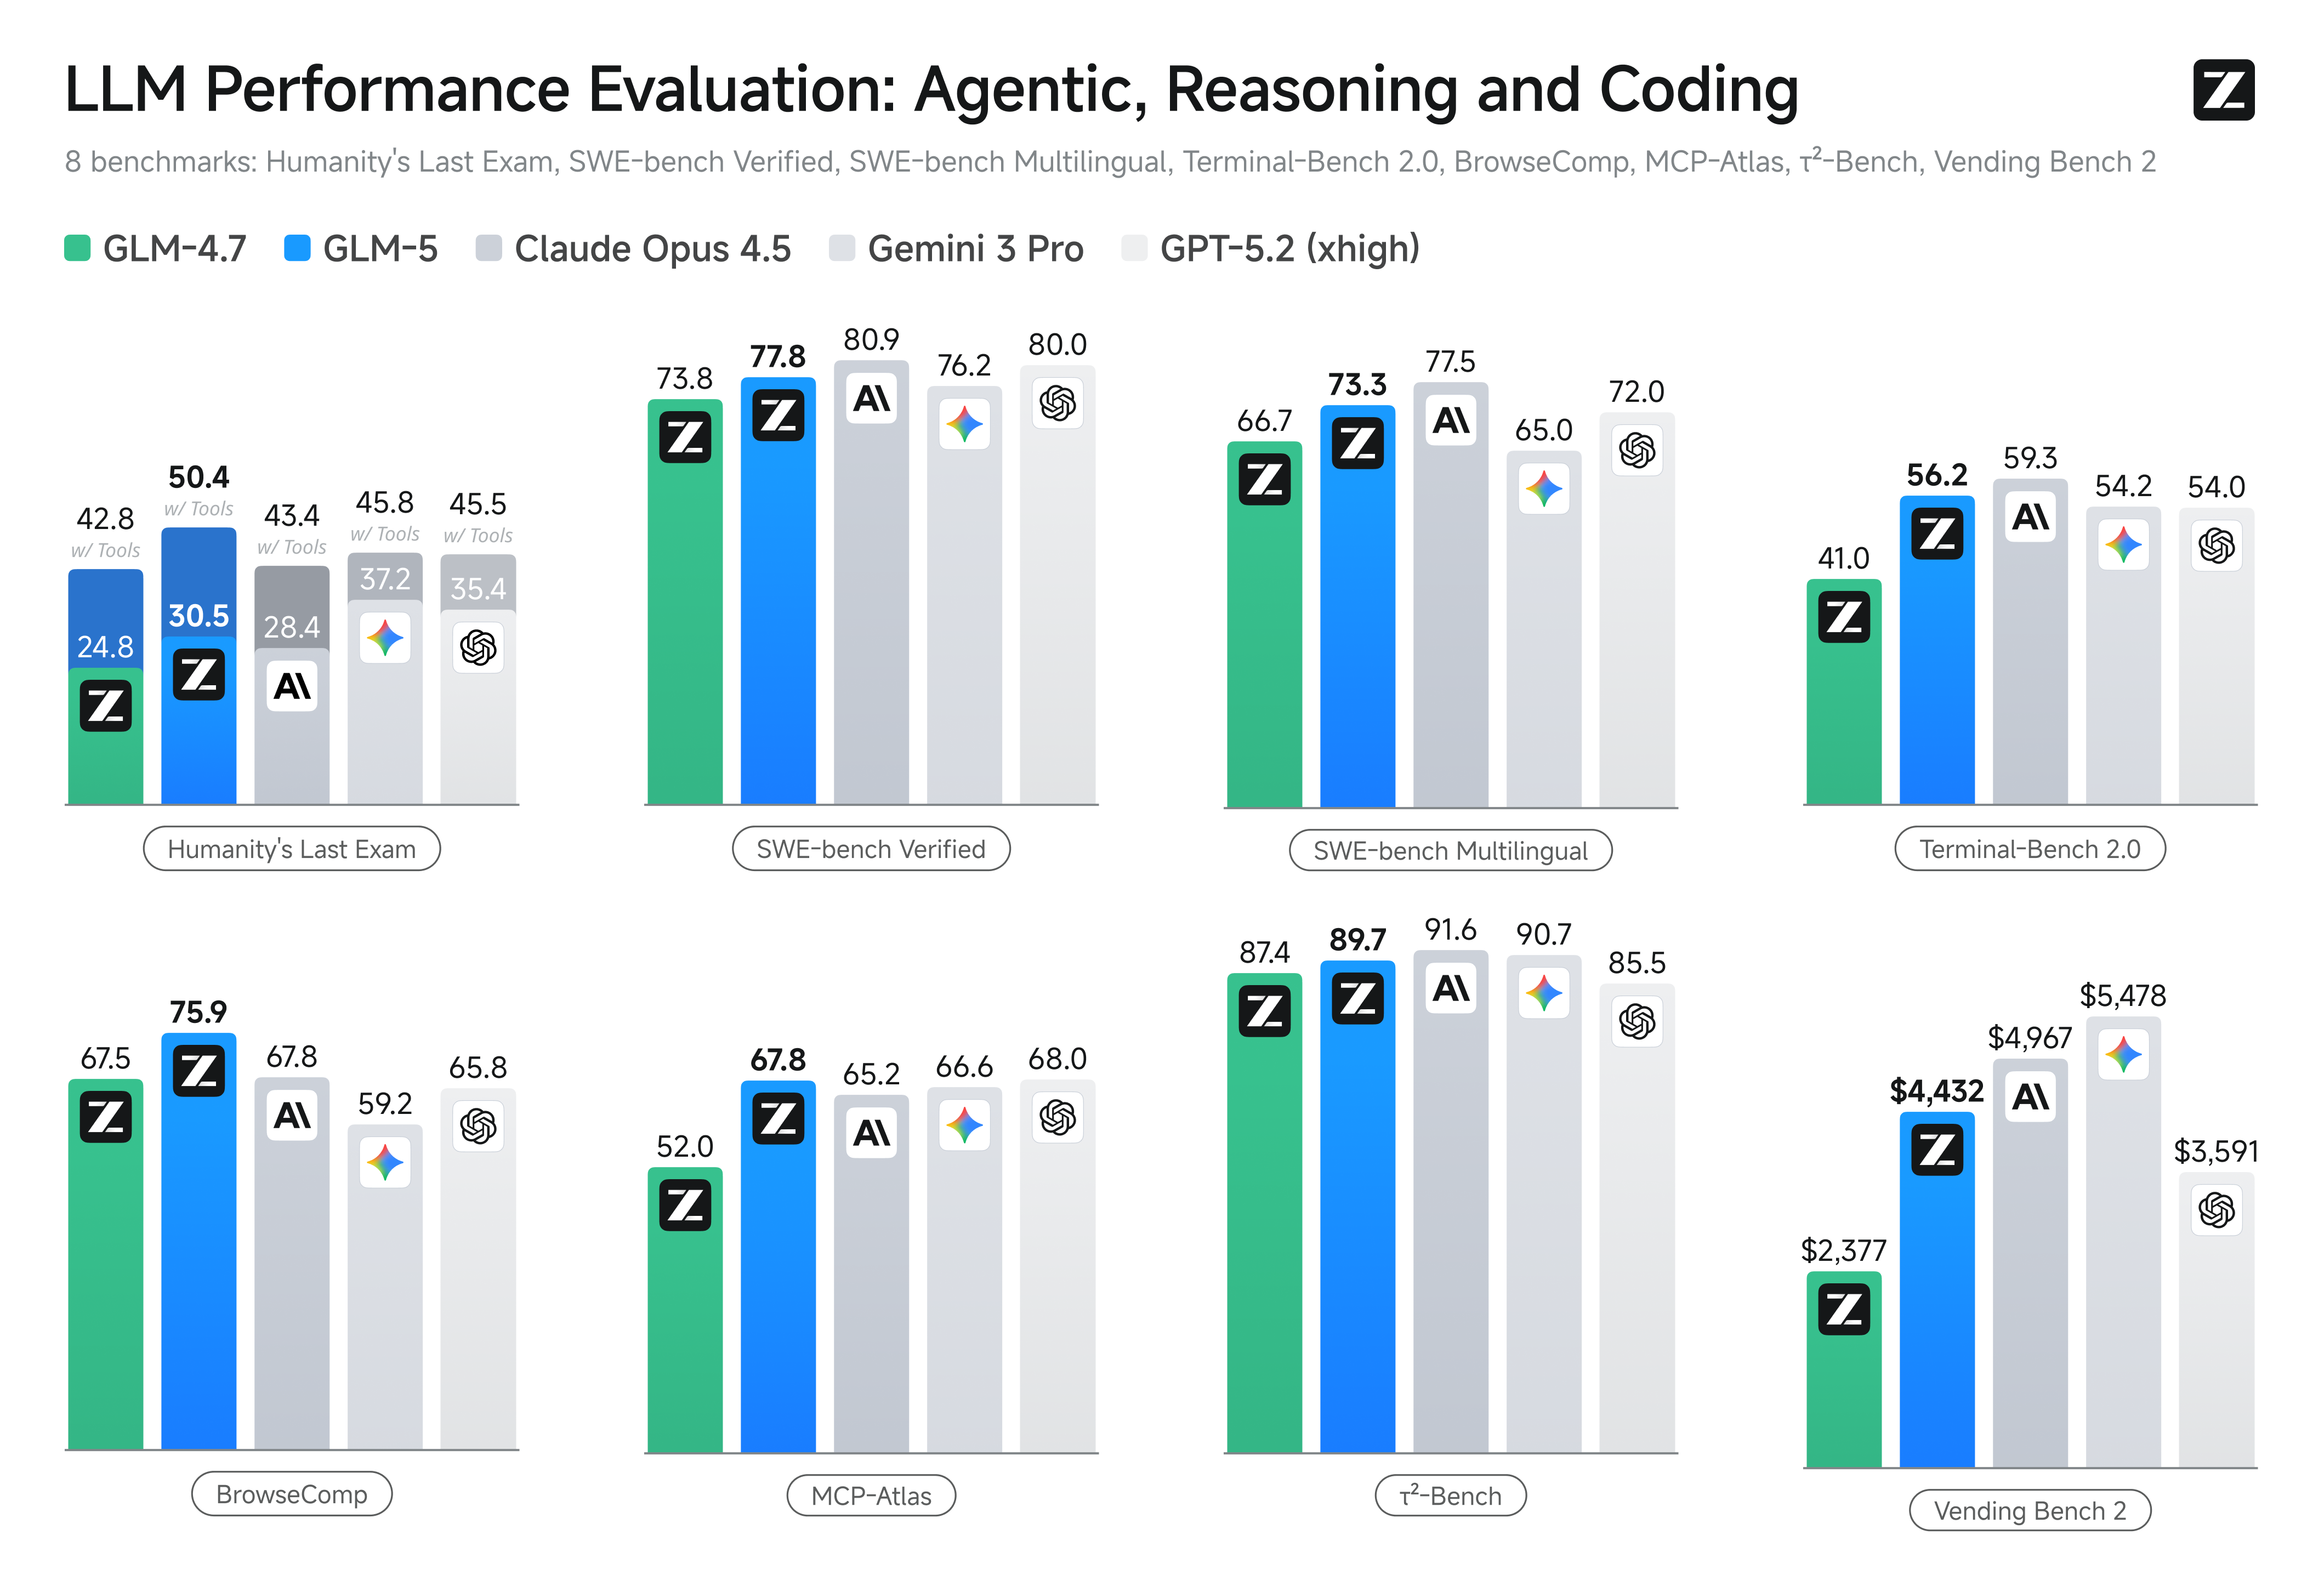
Hem ön eğitimde hem de son eğitimde sağlanan ilerlemelerle GLM-5, geniş bir akademik benchmark yelpazesinde GLM-4.7'ye kıyasla önemli bir iyileşme sunar ve akıl yürütme, kodlama ve ajan tabanlı görevlerde dünyadaki tüm açık kaynak modeller arasında sınıfının en iyi performansını elde ederek sınır modelleriyle arasındaki farkı kapatır.
GlmMoeDsaConfig
sınıf transformers.GlmMoeDsaConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 154880hidden_size: int = 6144intermediate_size: int = 12288moe_intermediate_size: int = 2048num_hidden_layers: int = 78num_attention_heads: int = 64num_key_value_heads: int = 64n_shared_experts: int = 1n_routed_experts: int = 256output_router_logits: bool = Falserouted_scaling_factor: float = 2.5kv_lora_rank: int = 512q_lora_rank: int = 2048qk_rope_head_dim: int = 64v_head_dim: int = 256qk_nope_head_dim: int = 192n_group: int = 1topk_group: int = 1num_experts_per_tok: int = 8norm_topk_prob: bool = Truehidden_act: str = 'silu'max_position_embeddings: int = 202752initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truepad_token_id: int | None = Nonebos_token_id: int | None = 0eos_token_id: int | list[int] | None = 1tie_word_embeddings: bool = Falserope_parameters: dict | None = Nonemlp_layer_types: list[str] | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0index_topk: int = 2048index_head_dim: int = 128index_n_heads: int = 32mlp_bias: bool = Falsehead_dim: int = 64first_k_dense_replace: int = 3layer_types: list[str] | None = Noneindexer_types: list[str] | None = None )
Parametreler
- vocab_size (
int, isteğe bağlı, varsayılan154880) — Modelin sözlük boyutu.input_idsile temsil edilebilecek farklı token sayısını belirler. - hidden_size (
int, isteğe bağlı, varsayılan6144) — Gizli temsillerin boyutu. - intermediate_size (
int, isteğe bağlı, varsayılan12288) — MLP temsillerinin boyutu. - moe_intermediate_size (
int, isteğe bağlı, varsayılan2048) — Yönlendirilen uzman MLP'lerinin ara boyutu. - num_hidden_layers (
int, isteğe bağlı, varsayılan78) — Transformer çözücüdeki gizli katman sayısı. - num_attention_heads (
int, isteğe bağlı, varsayılan64) — Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı. - num_key_value_heads (
int, isteğe bağlı, varsayılan64) — Bu, Grouped Query Attention uygulamasında kullanılacak key_value başlarının sayısıdır.num_key_value_heads=num_attention_headsise model Multi Head Attention (MHA) kullanır,num_key_value_heads=1ise model Multi Query Attention (MQA) kullanır, aksi halde GQA kullanılır. Çok başlı bir checkpoint'i GQA checkpoint'ine dönüştürürken, her grup key ve value başı, o gruptaki tüm orijinal başların ortalama havuzlanması (meanpooling) ile oluşturulmalıdır. Daha fazla ayrıntı için bu makaleye göz atın. Belirtilmezse, varsayılan olaraknum_attention_headskullanılır. - n_shared_experts (
int, isteğe bağlı, varsayılan1) — Paylaşılan uzman sayısı. - n_routed_experts (
int, isteğe bağlı, varsayılan256) — Yönlendirilen uzman sayısı. - output_router_logits (
bool, isteğe bağlı, varsayılanFalse) — Modelin router logits'lerini döndürüp döndürmeyeceği. Bu özelliğin etkinleştirilmesi, modelin yük dengeleme kaybı ve router z-kaybı dahil olmak üzere yardımcı kaybı da çıkarmasına olanak tanır. - routed_scaling_factor (
float, isteğe bağlı, varsayılan2.5) — Ölçekleme faktörü veya yönlendirilen uzmanlar. - kv_lora_rank (
int, isteğe bağlı, varsayılan512) — Anahtar ve değer projeksiyonları için LoRA matrislerinin rütbesi. - q_lora_rank (
int, isteğe bağlı, varsayılan2048) — Sorgu projeksiyonları için LoRA matrislerinin rütbesi. - qk_rope_head_dim (
int, isteğe bağlı, varsayılan64) — Döner konum gömme kullanan sorgu/anahtar başlarının boyutu. - v_head_dim (
int, isteğe bağlı, varsayılan256) — Değer başlıklarının boyutu. - qk_nope_head_dim (
int, isteğe bağlı, varsayılan192) — Rotary position embeddings kullanmayan sorgu/anahtar başlarının boyutu. - n_group (
int, isteğe bağlı, varsayılan 1) — Yönlendirilen uzmanlar için grup sayısı. - topk_group (
int, isteğe bağlı, varsayılan1) — Her token için seçilen grup sayısı (her token için, seçilen uzmanların yalnızcatopk_groupgrup içinde olmasını sağlar). - num_experts_per_tok (
int, isteğe bağlı, varsayılan8) — Her tokenın yönlendirileceği uzman sayısı. Bu, token seçimli yönlendirmede top-k değeridir. - norm_topk_prob (
bool, isteğe bağlı, varsayılanTrue) — Yönlendirilen uzmanların ağırlıklarının normalize edilip edilmeyeceği. - hidden_act (
str, isteğe bağlı, varsayılansilu) — Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin,"gelu","relu","silu"vb. - max_position_embeddings (
int, isteğe bağlı, varsayılan202752) — Bu modelin kullanılabileceği maksimum dizi uzunluğu. - initializer_range (
float, isteğe bağlı, varsayılan0.02) — Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması. - rms_norm_eps (
float, isteğe bağlı, varsayılan1e-05) — rms normalizasyon katmanları tarafından kullanılan epsilon. - use_cache (
bool, isteğe bağlı, varsayılanTrue) — Modelin son anahtar/değer dikkatlerini (tüm modellerde kullanılmaz) döndürüp döndürmeyeceği. Yalnızcaconfig.is_decoder=Trueolduğunda veya model yalnızca çözücü tabanlı üretken bir model olduğunda geçerlidir. - pad_token_id (
int, isteğe bağlı) — Sözlükte dolgu için kullanılan token kimliği. - bos_token_id (
int, isteğe bağlı, varsayılan0) — Sözlükte akış başlangıcı için kullanılan token kimliği. - eos_token_id (
Union[int, list[int]], isteğe bağlı, varsayılan1) — Sözlükte akış sonu için kullanılan token kimliği. - tie_word_embeddings (
bool, isteğe bağlı, varsayılanFalse) — Modelintied_weights_keyseşlemesine göre ağırlık gömme bağlamalarının yapılıp yapılmayacağı. - rope_parameters (
dict, isteğe bağlı) — RoPE gömme yapılandırma parametrelerini içeren sözlük. Sözlük,rope_thetaiçin bir değer ve daha uzunmax_position_embeddingsile RoPE kullanmak istiyorsanız ölçekleme için kullanılan isteğe bağlı parametreleri içermelidir. - mlp_layer_types (
list, isteğe bağlı) — Her katman için MLP tipi deseni ("dense"veya"sparse"). Varsayılan olarak 3 dense + kalanı sparse. - attention_bias (
bool, isteğe bağlı, varsayılanFalse) — Öz-dikkat sırasında sorgu, anahtar, değer ve çıktı projeksiyon katmanlarında önyargı (bias) kullanılıp kullanılmayacağı. - attention_dropout (
Union[float, int], isteğe bağlı, varsayılan0.0) — Dikkat olasılıkları için dropout oranı. - index_topk (
int, isteğe bağlı, varsayılan 2048) — Seyrek dikkat için indeksleyici tarafından seçilen en üst token sayısı. - index_head_dim (
int, isteğe bağlı, varsayılan 128) — Dizinleyici projeksiyonları için baş boyutu (DSA). - index_n_heads (
int, isteğe bağlı, varsayılan 32) — Dizinleyici projeksiyonları için baş sayısı (DSA). - mlp_bias (
bool, isteğe bağlı, varsayılanFalse) — MLP katmanlarındaki up_proj, down_proj ve gate_proj katmanlarında bias kullanılıp kullanılmayacağı. - head_dim (
int, isteğe bağlı, varsayılan64) — Dikkat başlığı boyutu. None ise, varsayılan olarak hidden_size // num_attention_heads değerini alır. - first_k_dense_replace (
int, isteğe bağlı, varsayılan 3) — Yoğun MLP kullanan baştaki katman sayısı; geri kalanı MoE bloğunu kullanır. - layer_types (
list[str], isteğe bağlı) — Her katman indeksini ilgili katman türüyle açıkça eşleyen bir liste. Sağlanmazsa, config değerlerine göre otomatik olarak oluşturulur. - indexer_types (
list[str], isteğe bağlı) — Katman başına indexer modu ("full"indexer'i çalıştırır,"shared"önceki tam katmanın top-k değerini yeniden kullanır). Varsayılan olarakindex_topk_freq/index_skip_topk_offset(veyaindex_topk_pattern)'den türetilen desene ayarlanır.
Bu, bir GlmMoeDsaModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Glm Moe Dsa modelinin örneklenmesinde, model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneklendiğinde, zai-org/GLM-5 ile benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
>>> from transformers import GlmMoeDsaConfig, GlmMoeDsaModel

>>> # Initializing a GLM-MoE-DSA configuration
>>> configuration = GlmMoeDsaConfig()

>>> # Initializing a model from the configuration
>>> model = GlmMoeDsaModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
GlmMoeDsaModel
sınıf transformers.GlmMoeDsaModel
< source >( config: GlmMoeDsaConfig )
Parametreler
- config (GlmMoeDsaConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
Üzerinde herhangi bir özel head olmadan ham hidden-state çıktısı üreten çıplak Glm Moe Dsa Model.
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
Parametreler
- input_ids (
torch.LongTensorşeklinde(batch_size, sequence_length), isteğe bağlı) — Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yok sayılır.Dizinler AutoTokenizer kullanılarak elde edilebilir. Ayrıntılar için PreTrainedTokenizer.encode() ve PreTrainedTokenizer.call() konularına bakın.
- attention_mask (
torch.Tensorşeklinde(batch_size, sequence_length), isteğe bağlı) — Doldurma (padding) token indekslerinde dikkat (attention) işlemi yapmaktan kaçınmak için kullanılan maske. Seçilen maske değerleri[0, 1]:- 1, maskelenmemiş jetonlar için,
- maskelenmiş jetonlar için 0.
- position_ids (
torch.LongTensorşeklinde(batch_size, sequence_length), isteğe bağlı) — Girdi dizilerindeki her token'ın konum gömme (position embedding) içindeki konum indeksleri. Seçim aralığı[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, isteğe bağlı) — Sıralı çözümlemeyi hızlandırmak için kullanılabilen önceden hesaplanmış gizli durumlar (self-attention ve cross-attention bloklarındaki anahtar ve değerler). Bu genelliklepast_key_valuesdeğerinin, çözümlemenin önceki bir aşamasında model tarafından döndürülenuse_cache=Trueveyaconfig.use_cache=True.Girdi olarak yalnızca Cache örneği kabul edilir, kv cache kılavuzumuza bakın.
past_key_valuesgeçirilmezse, varsayılan olarak DynamicCache başlatılır.Model, girdi olarak verilen aynı önbellek biçimini çıktı olarak üretecektir.
past_key_valueskullanılıyorsa, kullanıcının tüminput_ids(şekli(batch_size, sequence_length)) yerine, bu modele geçmiş anahtar değer durumları verilmemiş olan, işlenmemişinput_ids(şekli(batch_size, unprocessed_length)) girmesi beklenir. - inputs_embeds (
torch.Tensor, şekli(batch_size, sequence_length, hidden_size), isteğe bağlı) — İsteğe bağlı olarak,input_idsyerine gömülü bir temsil doğrudan geçmeyi tercih edebilirsiniz. Bu,input_idsdizinlerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisinden daha fazla kontrol sahibi olmak istiyorsanız faydalıdır. - use_cache (
bool, isteğe bağlı) —Trueolarak ayarlanırsa,past_key_valuesanahtar değer durumları döndürülür ve çözümlemeyi hızlandırmak için kullanılabilir (bkz.past_key_values).
Dönüş değeri
MoeModelOutputWithPast veya tuple(torch.Tensor)
MoeModelOutputWithPast veya bir torch.Tensor demeti (eğer return_dict=False geçirildiyse veya config.return_dict=False ise), yapılandırma (GlmMoeDsaConfig) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
GlmMoeDsaModel forward metodu, __call__ özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine
Moduleörneğini çağırmak gerekir; çünkü önceki, ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
last_hidden_state (
torch.Tensor, şekli(batch_size, sequence_length, hidden_size)) — Modelin son katmanının çıktısındaki gizli durumlar dizisi.past_key_values (
Cache, isteğe bağlı,use_cache=Truegeçirildiğinde veyaconfig.use_cache=Trueolduğunda döndürülür) — Bir Cache örneğidir. Daha fazla ayrıntı için kv cache kılavuzumuza bakın.Sıralı çözümlemeyi hızlandırmak için (bkz.
past_key_valuesgirdisi) kullanılabilen, önceden hesaplanmış gizli durumları (self-attention bloklarındaki anahtar ve değerler ve isteğe bağlı olarakconfig.is_encoder_decoder=Trueise cross-attention bloklarındaki anahtar ve değerler) içerir.hidden_states (
tuple(torch.Tensor), isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren,(batch_size, sequence_length, hidden_size)biçiminde bir demet.Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
attentions (
tuple(torch.Tensor), isteğe bağlı,output_attentions=Truegeçirildiğinde veyaconfig.output_attentions=Trueolduğunda döndürülür) —torch.Tensor(katman başına bir tane) içeren bir tuple, şekli(batch_size, num_heads, sequence_length, sequence_length).Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat başlıklarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
router_logits (
tuple(torch.Tensor), isteğe bağlı,output_router_probs=Trueveconfig.add_router_probs=Truegeçirildiğinde veyaconfig.output_router_probs=Trueolduğunda döndürülür) —torch.Tensor(katman başına bir tane) içeren bir tuple, şekli(batch_size, sequence_length, num_experts).MoE yönlendiricileri tarafından hesaplanan ham yönlendirici logitleri (softmax sonrası), bu terimler Mixture of Experts modelleri için yardımcı kaybı hesaplamakta kullanılır.
GlmMoeDsaForCausalLM
sınıf transformers.GlmMoeDsaForCausalLM
< source >( config: GlmMoeDsaConfig )
Parametreler
- config (GlmMoeDsaConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
Nedensel dil modellemesi için Glm Moe Dsa Modeli.
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
Parametreler
- input_ids (
torch.LongTensorşeklinde(batch_size, sequence_length), isteğe bağlı) — Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yok sayılır.Dizinler AutoTokenizer kullanılarak elde edilebilir. Ayrıntılar için PreTrainedTokenizer.encode() ve PreTrainedTokenizer.call() konularına bakın.
- attention_mask (
torch.Tensorşeklinde(batch_size, sequence_length), isteğe bağlı) — Doldurma (padding) token indekslerinde dikkat (attention) işlemi yapmaktan kaçınmak için kullanılan maske. Seçilen maske değerleri[0, 1]:- 1, maskelenmemiş jetonlar için,
- maskelenmiş jetonlar için 0.
- position_ids (
torch.LongTensorşeklinde(batch_size, sequence_length), isteğe bağlı) — Girdi dizilerindeki her token'ın konum gömme (position embedding) içindeki konum indeksleri. Seçim aralığı[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, isteğe bağlı) — Sıralı çözümlemeyi hızlandırmak için kullanılabilen önceden hesaplanmış gizli durumlar (self-attention ve cross-attention bloklarındaki anahtar ve değerler). Bu genelliklepast_key_valuesdeğerinin, çözümlemenin önceki bir aşamasında model tarafından döndürülenuse_cache=Trueveyaconfig.use_cache=True.Girdi olarak yalnızca Cache örneği kabul edilir, kv cache kılavuzumuza bakın.
past_key_valuesgeçirilmezse, varsayılan olarak DynamicCache başlatılır.Model, girdi olarak verilen aynı önbellek biçimini çıktı olarak üretecektir.
past_key_valueskullanılıyorsa, kullanıcının tüminput_ids(şekli(batch_size, sequence_length)) yerine, bu modele geçmiş anahtar değer durumları verilmemiş olan, işlenmemişinput_ids(şekli(batch_size, unprocessed_length)) girmesi beklenir. - inputs_embeds (
torch.Tensor, şekli(batch_size, sequence_length, hidden_size), isteğe bağlı) — İsteğe bağlı olarak,input_idsyerine gömülü bir temsil doğrudan geçmeyi tercih edebilirsiniz. Bu,input_idsdizinlerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisinden daha fazla kontrol sahibi olmak istiyorsanız faydalıdır. - labels (
torch.LongTensor, şekli(batch_size, sequence_length), isteğe bağlı) — Maskeli dil modelleme kaybını hesaplamak için etiketler. Endeksler[0, ..., config.vocab_size]aralığında olmalı ya da -100 olmalı (input_idsdocstring'ine bakın). Endeksleri-100olarak ayarlanan tokenlar yok sayılır (maskelenir), kayıp yalnızca etiketleri[0, ..., config.vocab_size]aralığında olan tokenlar için hesaplanır. - use_cache (
bool, isteğe bağlı) —Trueolarak ayarlanırsa,past_key_valuesanahtar değer durumları döndürülür ve çözümlemeyi hızlandırmak için kullanılabilir (bkz.past_key_values). - logits_to_keep (
Union[int, torch.Tensor], isteğe bağlı, varsayılan0) —intise, sonlogits_to_keeptoken için logits hesaplanır.0ise, tüminput_idsiçin logits hesaplanır (özel durum). Üretim için yalnızca son token logits'leri gereklidir ve bunların yalnızca o token için hesaplanması bellek tasarrufu sağlar; bu, uzun diziler veya büyük sözlük boyutu için oldukça önemli hale gelir.torch.Tensorise, dizi uzunluğu boyutundaki korunacak indekslere karşılık gelen 1B olmalıdır. Bu, paketlenmiş tensor biçimini (batch ve dizi uzunluğu için tek boyut) kullanırken faydalıdır.
Dönüş değeri
MoeCausalLMOutputWithPast veya tuple(torch.Tensor)
MoeCausalLMOutputWithPast veya bir torch.Tensor demeti (return_dict=False geçirildiğinde veya config.return_dict=False olduğunda), yapılandırmaya (GlmMoeDsaConfig) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
GlmMoeDsaForCausalLM forward metodu, __call__ özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine
Moduleörneğini çağırmak gerekir; çünkü önceki, ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
loss (
torch.Tensor, şekli(1,), isteğe bağlı,labelssağlandığında döndürülür) — Dil modelleme kaybı (sonraki token tahmini için).logits (
torch.Tensor, şekli(batch_size, sequence_length, config.vocab_size)) — Dil modelleme başlığının tahmin puanları (SoftMax öncesi her sözlük jetonu için puanlar).aux_loss (
torch.Tensor, isteğe bağlı,output_router_logits=Truegeçirildiğinde veyaconfig.output_router_logits=Trueolduğunda ve model, yük dengeleme kaybı ile router'ını eğittiğinde döndürülür) — Seyrek modüller için yük dengeleme yardımcı kaybı. Uzmanlarını router sapması ile dengeleyen modeller (DeepSeek-V3 ve ondan türetilen mimariler) buradaNonedöndürürken yine derouter_logitsdöndürür.router_logits (
tuple(torch.Tensor), isteğe bağlı,output_router_logits=Truegeçirildiğinde veyaconfig.output_router_logits=Trueolduğunda döndürülür) —torch.Tensor(her seyrek katman için bir tane) içeren bir tuple, şekli(batch_size * sequence_length, num_experts).MoE yönlendiricileri tarafından hesaplanan ham yönlendirici logitleri. Bunlar, bir yük dengeleme kaybı hesaplamak veya tokenlerin uzmanlara nasıl dağıtıldığını incelemek için kullanılabilir.
past_key_values (
Cache, isteğe bağlı,use_cache=Truegeçirildiğinde veyaconfig.use_cache=Trueolduğunda döndürülür) — Bir Cache örneğidir. Daha fazla ayrıntı için kv cache kılavuzumuza bakın.Sıralı çözümlemeyi hızlandırmak için (bkz.
past_key_valuesgirdisi) kullanılabilen, önceden hesaplanmış gizli durumları (self-attention bloklarındaki anahtar ve değerler) içerir.hidden_states (
tuple(torch.Tensor), isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren,(batch_size, sequence_length, hidden_size)biçiminde bir demet.Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
attentions (
tuple(torch.Tensor), isteğe bağlı,output_attentions=Truegeçirildiğinde veyaconfig.output_attentions=Trueolduğunda döndürülür) —torch.Tensor(katman başına bir tane) içeren bir tuple, şekli(batch_size, num_heads, sequence_length, sequence_length).Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat başlıklarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnek:
>>> from transformers import AutoTokenizer, GlmMoeDsaForCausalLM

>>> model = GlmMoeDsaForCausalLM.from_pretrained("meta-glm_moe_dsa/GlmMoeDsa-2-7b-hf")
>>> tokenizer = AutoTokenizer.from_pretrained("meta-glm_moe_dsa/GlmMoeDsa-2-7b-hf")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."