
Transformers documentation
Ernie 4.5
该模型于 2025-07-21 贡献至 Hugging Face Transformers。



Ernie 4.5
概述
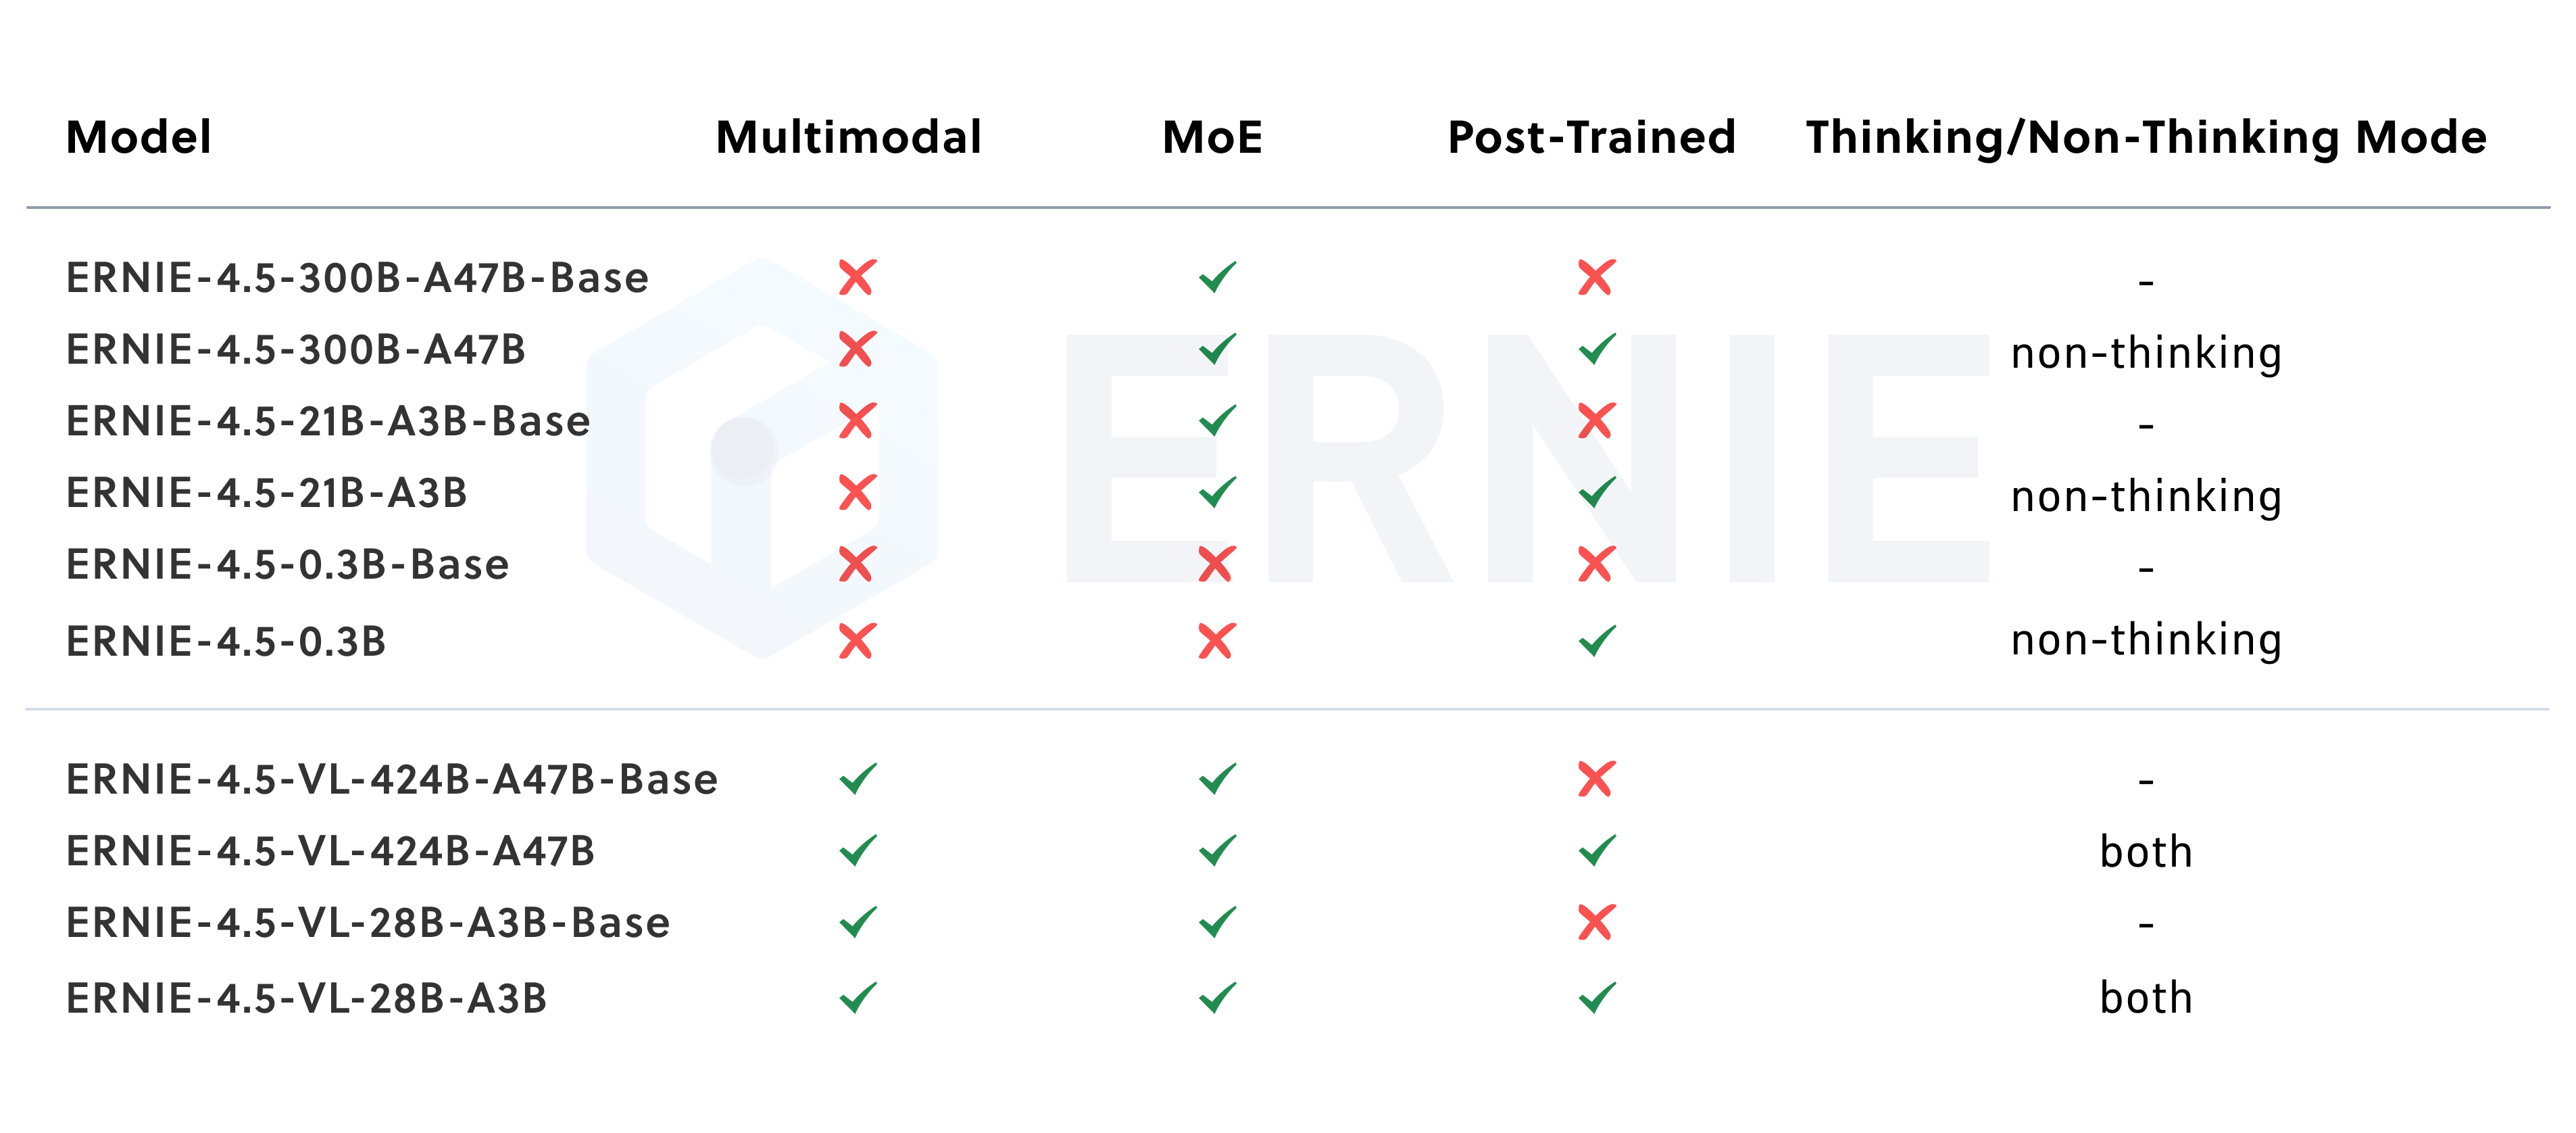
Ernie 4.5 模型由 baidu 在 Ernie 4.5 Model Family 发布中推出。 该模型家族包含多种不同的架构和模型规模。具体而言,该模型针对的是不含混合专家(moe)的基础文本模型,总参数量为 0.3B。其核心采用标准的 Llama。
该系列的其他模型可在 Ernie 4.5 Moe 和 Ernie 4.5 VL MoE 中找到。
使用技巧
生成文本
from transformers import AutoModelForCausalLM, AutoTokenizer


model_name = "baidu/ERNIE-4.5-0.3B-PT"

# load the tokenizer and the model
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
)

# prepare the model input
inputs = tokenizer("Hey, are you conscious? Can you talk to me?", return_tensors="pt").to(model.device)
prompt = "Hey, are you conscious? Can you talk to me?"
messages = [
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], add_special_tokens=False, return_tensors="pt").to(model.device)

# conduct text completion
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=32,
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

# decode the generated ids
generate_text = tokenizer.decode(output_ids, skip_special_tokens=True)
该模型由 Anton Vlasjuk 贡献。 原始代码可在此处找到。
Ernie4_5Config
class transformers.Ernie4_5Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 103424hidden_size: int = 1024intermediate_size: int = 3072num_hidden_layers: int = 18num_attention_heads: int = 16num_key_value_heads: int | None = 2hidden_act: str = 'silu'max_position_embeddings: int = 131072initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool | None = Truepad_token_id: int | None = 0bos_token_id: int | None = 1eos_token_id: int | list[int] | None = 2tie_word_embeddings: bool = Truerope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = Noneuse_bias: bool | None = Falsehead_dim: int | None = 128 )
参数
- vocab_size (
int,可选,默认为103424) — 模型的词汇表大小。定义了input_ids可以表示的不同 token 数量。 - hidden_size (
int,可选,默认为1024) — 隐藏表示的维度。 - intermediate_size (
int,可选,默认为3072) — MLP 表示的维度。 - num_hidden_layers (
int, 可选,默认为18) — Transformer 解码器中的隐藏层数量。 - num_attention_heads (
int,可选,默认为16) — Transformer 解码器中每个注意力层的注意力头数量。 - num_key_value_heads (
int, 可选,默认为2) — 这是用于实现 Grouped Query Attention 的 key_value 头数。如果num_key_value_heads=num_attention_heads,模型将使用 Multi Head Attention (MHA);如果num_key_value_heads=1,模型将使用 Multi Query Attention (MQA);否则将使用 GQA。在将多头检查点转换为 GQA 检查点时,每个组的 key 和 value 头应通过对该组内所有原始头进行平均池化来构建。更多详情请参阅 这篇论文。如果未指定,则默认为num_attention_heads。 - hidden_act (
str,可选,默认为silu) — 解码器中的非线性激活函数(函数或字符串)。例如,"gelu"、"relu"、"silu"等。 - max_position_embeddings (
int,可选,默认为131072) — 该模型可能使用的最大序列长度。 - initializer_range (
float,可选,默认为0.02) — 用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。 - rms_norm_eps (
float,可选,默认为1e-05) — RMS 归一化层使用的 epsilon 值。 - use_cache (
bool,可选,默认为True) — 模型是否应返回最后一次键/值注意力(并非所有模型都使用)。仅当config.is_decoder=True或模型为仅解码器生成式模型时相关。 - pad_token_id (
int, 可选,默认为0) — 词表中用于填充的 token id。 - bos_token_id (
int,可选,默认为1) — 词汇表中用于表示流起始的 token id。 - eos_token_id (
Union[int, list[int]],可选,默认为2) — 词汇表中用于表示流结束(end-of-stream)的 token id。 - tie_word_embeddings (
bool,可选,默认为True) — 是否根据模型的tied_weights_keys映射来绑定权重嵌入。 - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], 可选) — 包含 RoPE 嵌入配置参数的字典。该字典应包含rope_theta的值,并且如果希望使用 RoPE 处理更长的max_position_embeddings,则可选地包含用于缩放的参数。 - use_bias (
bool,可选,默认为False) — 是否在任何投影(例如 mlp 和 attention)中使用偏置。 - head_dim (
int,可选,默认为128) — 注意力头维度。如果为 None,则默认为 hidden_size // num_attention_heads
这是用于存储 Ernie4_5Model 配置的类。它根据指定的参数实例化 Ernie4 5 模型,并定义模型架构。使用默认值实例化配置将生成与 baidu/ERNIE-4.5-0.3B-PT 类似的配置。
配置对象继承自 PreTrainedConfig,可用于控制模型输出。有关更多信息,请参阅 PreTrainedConfig 的文档。
示例:
>>> from transformers import Ernie4_5Model, Ernie4_5Config

>>> # Initializing a Ernie4_5 0.3B style configuration
>>> configuration = Ernie4_5Config()

>>> # Initializing a model from the 0.3B style configuration
>>> model = Ernie4_5Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Ernie4_5Model
class transformers.Ernie4_5Model
< source >( config: Ernie4_5Config )
参数
- config (Ernie4_5Config) — 模型的配置类,包含模型的所有参数。使用配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 from_pretrained() 方法以加载模型权重。
未添加任何特定头部的裸 Ernie4 5 模型,直接输出原始隐藏状态。
该模型继承自 PreTrainedModel。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch torch.nn.Module 的子类。 请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPast or tuple(torch.Tensor)
参数
- input_ids (
torch.LongTensor形状为(batch_size, sequence_length), ,可选) — 输入序列中各 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 AutoTokenizer 获取索引。有关详细信息,请参阅 PreTrainedTokenizer.encode() 和 PreTrainedTokenizer.call()。
- attention_mask (
torch.Tensor形状为(batch_size, sequence_length), ,可选) — 用于避免对填充 token 索引执行注意力机制的掩码。掩码值取自[0, 1]:- 1 表示未被屏蔽的 token,
- 对于被掩码的 token,值为 0。
- position_ids (
torch.LongTensor形状为(batch_size, sequence_length), 可选) — 输入序列中每个 token 在位置嵌入中的位置索引。取值范围为[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 可选) — 预计算的隐藏状态(自注意力块和交叉注意力块中的键和值),可用于加速顺序解码。这通常由past_key_values在解码的先前阶段返回,当use_cache=True或config.use_cache=True.仅允许将 Cache 实例作为输入,请参阅我们的 kv cache 指南。 如果未传入
past_key_values,则默认会初始化 DynamicCache。模型将输出与输入相同的缓存格式。
如果使用了
past_key_values,用户应仅输入未处理的input_ids(即未向该模型提供其过去键值状态的那些),其形状为(batch_size, unprocessed_length),而不是形状为(batch_size, sequence_length)的全部input_ids。 - inputs_embeds(形状为
(batch_size, sequence_length, hidden_size)的torch.Tensor,可选) — 可选地,您可以选择直接传入嵌入表示,而不是传入input_ids。如果您希望对input_ids索引如何转换为相应向量拥有比模型内部嵌入查找矩阵更多的控制权,这将非常有用。 - use_cache (
bool,可选) — 如果设置为True,则会返回past_key_values键值状态,可用于加速解码(参见past_key_values)。
返回值
BaseModelOutputWithPast 或 tuple(torch.Tensor)
一个 BaseModelOutputWithPast 或 torch.Tensor 元组(如果传入了 return_dict=False 或 config.return_dict=False),其包含的元素取决于配置(Ernie4_5Config)和输入。
Ernie4_5Model 的 forward 方法重写了 __call__ 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用
Module实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者则会静默地忽略这些步骤。
last_hidden_state(形状为
(batch_size, sequence_length, hidden_size)的torch.Tensor)— 模型最后一层输出的隐藏状态序列。如果使用了
past_key_values,则仅输出形状为(batch_size, 1, hidden_size)的序列的最后一个隐藏状态。past_key_values(
Cache,可选,在传入use_cache=True或config.use_cache=True时返回)—— 它是一个 Cache 实例。更多详情,请参阅我们的 kv cache 指南。包含预计算的隐藏状态(自注意力块中的键和值,以及如果
config.is_encoder_decoder=True则还包括交叉注意力块中的键和值),可用于(参见past_key_values输入)加速顺序解码。hidden_states (
tuple(torch.Tensor),可选,当传入output_hidden_states=True或config.output_hidden_states=True时返回) — 一个torch.Tensor元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为(batch_size, sequence_length, hidden_size)。模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
attentions (
tuple(torch.Tensor),可选,当传入output_attentions=True或config.output_attentions=True时返回) — 一个torch.Tensor元组(每层一个),形状为(batch_size, num_heads, sequence_length, sequence_length)。注意力权重,即经过注意力 softmax 之后的权重,用于在自注意力头中计算加权平均值。
Ernie4_5ForCausalLM
类 transformers.Ernie4_5ForCausalLM
< source >( config: Ernie4_5Config )
参数
- config (Ernie4_5Config) — 模型的配置类,包含模型的所有参数。使用配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 from_pretrained() 方法以加载模型权重。
用于因果语言建模的 Ernie4 5 模型。
该模型继承自 PreTrainedModel。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch torch.nn.Module 的子类。 请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CausalLMOutputWithPast or tuple(torch.Tensor)
参数
- input_ids (
torch.LongTensor形状为(batch_size, sequence_length), ,可选) — 输入序列中各 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 AutoTokenizer 获取索引。有关详细信息,请参阅 PreTrainedTokenizer.encode() 和 PreTrainedTokenizer.call()。
- attention_mask (
torch.Tensor形状为(batch_size, sequence_length), ,可选) — 用于避免对填充 token 索引执行注意力机制的掩码。掩码值取自[0, 1]:- 1 表示未被屏蔽的 token,
- 对于被掩码的 token,值为 0。
- position_ids (
torch.LongTensor形状为(batch_size, sequence_length), 可选) — 输入序列中每个 token 在位置嵌入中的位置索引。取值范围为[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, 可选) — 预计算的隐藏状态(自注意力块和交叉注意力块中的键和值),可用于加速顺序解码。这通常由past_key_values在解码的先前阶段返回,当use_cache=True或config.use_cache=True.仅允许将 Cache 实例作为输入,请参阅我们的 kv cache 指南。 如果未传入
past_key_values,则默认会初始化 DynamicCache。模型将输出与输入相同的缓存格式。
如果使用了
past_key_values,用户应仅输入未处理的input_ids(即未向该模型提供其过去键值状态的那些),其形状为(batch_size, unprocessed_length),而不是形状为(batch_size, sequence_length)的全部input_ids。 - inputs_embeds(形状为
(batch_size, sequence_length, hidden_size)的torch.Tensor,可选) — 可选地,您可以选择直接传入嵌入表示,而不是传入input_ids。如果您希望对input_ids索引如何转换为相应向量拥有比模型内部嵌入查找矩阵更多的控制权,这将非常有用。 - labels (
torch.LongTensor,形状为(batch_size, sequence_length),可选) — 用于计算掩码语言建模损失的标签。索引值应在[0, ..., config.vocab_size]范围内,或为 -100(参见input_ids的文档字符串)。索引值设为-100的 token 将被忽略(即被掩码),损失仅针对标签位于[0, ..., config.vocab_size]范围内的 token 进行计算。 - use_cache (
bool,可选) — 如果设置为True,则会返回past_key_values键值状态,可用于加速解码(参见past_key_values)。 - logits_to_keep (
Union[int, torch.Tensor], 可选,默认为0) — 如果为int,则计算最后logits_to_keep个 token 的 logits。如果为0,则计算所有input_ids的 logits(特殊情况)。生成过程只需要最后一个 token 的 logits,仅针对该 token 进行计算可以节省内存,对于长序列或大词汇量而言,这种节省相当显著。 如果为torch.Tensor,则必须是一维张量,对应于序列长度维度中需要保留的索引。 这在使用打包张量格式(将批次和序列长度合并为单一维度)时非常有用。
返回值
CausalLMOutputWithPast 或 tuple(torch.Tensor)
一个 CausalLMOutputWithPast 或 torch.Tensor 元组(如果传入了 return_dict=False 或 config.return_dict=False),其包含的元素取决于配置(Ernie4_5Config)和输入。
Ernie4_5ForCausalLM 的 forward 方法重写了 __call__ 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用
Module实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者则会静默地忽略这些步骤。
loss (
torch.Tensor,形状为(1,),可选,当提供labels时返回) — 语言建模损失(用于下一个 token 预测)。logits(形状为
(batch_size, sequence_length, config.vocab_size)的torch.Tensor)— 语言建模头的预测分数(SoftMax 之前每个词汇表 token 的分数)。past_key_values(
Cache,可选,在传入use_cache=True或config.use_cache=True时返回)—— 它是一个 Cache 实例。更多详情,请参阅我们的 kv cache 指南。包含预计算的隐藏状态(自注意力块中的键和值),可用于(参见
past_key_values输入)加速顺序解码。hidden_states (
tuple(torch.Tensor),可选,当传入output_hidden_states=True或config.output_hidden_states=True时返回) — 一个torch.Tensor元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为(batch_size, sequence_length, hidden_size)。模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
attentions (
tuple(torch.Tensor),可选,当传入output_attentions=True或config.output_attentions=True时返回) — 一个torch.Tensor元组(每层一个),形状为(batch_size, num_heads, sequence_length, sequence_length)。注意力权重,即经过注意力 softmax 之后的权重,用于在自注意力头中计算加权平均值。